论文理解【LLM-OR】——【OptMATH】A Scalable Bidirectional Data Synthesis Framework for Optimization Modeling
本文初稿使用 PaperReading-skill 生成。给定论文标题、链接、arXiv/OpenReview 页面、DOI 或本地 PDF,让 Codex 自动完成论文检索、PDF 下载、图表抽取、代码仓库分析,并生成一份适合 Typora 阅读和后续整理的中文论文解读 Markdown 和 PDF,欢迎试用!
- 首发链接:论文理解【LLM-OR】——【OptMATH】A Scalable Bidirectional Data Synthesis Framework for Optimization Modeling
- 文章链接:OptMATH: A Scalable Bidirectional Data Synthesis Framework for Optimization Modeling
- 作者:Hongliang Lu, Zhonglin Xie, Yaoyu Wu, Can Ren, Yuxuan Chen, Zaiwen Wen
- 机构:Peking University, Beijing International Center for Mathematical Research, School of Mathematical Sciences
- 代码:optsuite/OptMATH
- 项目页:OptMATH Project
- 发表:ICML 2025, PMLR 267:40769-40802
- 领域:LLM-OR
- 一句话总结:使用 LLM 进行 OR 问题建模时,现有方法受限于高质量训练数据稀缺、合成数据复杂度和一致性不足,难以泛化到复杂长文本优化问题;本文提出 OptMATH,从已有 MF/PD 出发反向生成 NL,再通过 AutoFormulator 正向建模和最优值匹配 rejection sampling 验证语义一致性,构建 OptMATH-Train 与 OptMATH-Bench,并通过 SFT/LoRA 训练 AutoFormulator,显著提升了 0.5B–32B 模型在 NL4OPT、MAMO 和 OptMATH-Bench 上的优化建模准确率
- 摘要:尽管大语言模型发展迅速,一个根本挑战仍然存在:缺乏高质量的优化建模数据集,这阻碍了 LLM 从自然语言描述(NL)中鲁棒地建模实际优化问题,也导致学习式方法泛化困难。为了解决这些挑战,我们提出了 OptMATH —— 一种可扩展的高质量数据集合成框架。该框架从带有数学公式(MF)的人工整理种子数据出发,自动生成复杂度可控的问题数据(PD),然后使用反向翻译步骤获得 NL,并结合前向建模结合和拒绝采样法来验证NL与PD的一致性。被接受的样本对质量较高,构成 OptMATH 的训练部分。随后,一组被拒绝的样本对被识别并进一步过滤,并构成新的优化建模 Benchmark,其中包含长度远长于 NL4OPT 和 MAMO 的困难实例。通过大量实验,作者证明在 OptMATH 上训练的 0.5B 到 32B 参数规模模型,在多个建模 Benchmark 上取得更优结果,从而验证了该方法的有效性和可扩展性
1. 背景
- 本文研究优化问题的自动建模与编程,以减轻对人类专家的严重依赖。具体而言,这类问题要求输入一段自然语言描述的问题(如配送货、生产规划等问题),要求模型或系统完成运筹学建模,并生成问题求解代码,中间常需要显式写出数学公式 (MF)。
这里的难点不是 “会不会算最优解”,而是 “能不能把题意里的变量、目标、约束、整数性、Big-M 逻辑、业务条件翻译成正确模型”。这类任务比小学数学题更开放:同一个业务问题可能有多种等价建模方式,约束也常隐含在上下文里
- 针对该任务,当前主要存在基于提示和基于微调的两类方法:
- 基于提示的建模prompt-based modeling:通过为 GPT-4o 等大规模预训练 LLM 精心设计建模 Prompt 来工作,相关方法包括 OptiTree、PaMOP、OptiMUS 等。这类方法的重点在于通过引入树、图、多智能体等设计,将 “复杂问题描述上下文 -> 严格式要求代码” 的端到端生成过程拆分为多个子过程,从而降低各环节难度,并使各环节的 prompt 更具针对性和指向性
这类方法的优势是不改模型参数,工程上容易迭代;弱点是很依赖基础模型本身的优化建模知识,复杂长题中容易漏约束或变量类型
- 基于微调的建模fine-tuned LLM modeling agents:通过构造大规模运筹学及建模知识对 LLM 进行微调,形成专用的建模语言模型,如 ORLM、Step-Opt 等。这类方法的重点在于设计数据构方法和错误过滤方法,实现多样、正确、难度可控的高质量数据集。此外,从 2025 年开始也逐步出现了基于 RL post-training 的方法,如 SIRL 将 OR 建模求解视作 RLVR 任务解决、LLMOPT 使用在 sft 后使用 KTO 后训练减弱模型幻觉等
通过进行针对性训练,基于微调的方法往往可以用更小参数量的模型达成和通用大模型相似的性能,但问题在于真实高质量优化建模样本少,人工标注贵,简单数据又无法覆盖长上下文、复杂约束和跨领域表达
- 基于提示的建模prompt-based modeling:通过为 GPT-4o 等大规模预训练 LLM 精心设计建模 Prompt 来工作,相关方法包括 OptiTree、PaMOP、OptiMUS 等。这类方法的重点在于通过引入树、图、多智能体等设计,将 “复杂问题描述上下文 -> 严格式要求代码” 的端到端生成过程拆分为多个子过程,从而降低各环节难度,并使各环节的 prompt 更具针对性和指向性
2. 本文方法
-
OptMATH 通过三元组语义对齐(NL、MF、PD)进行数据生成及严格验证,解决优化建模中数据稀缺这一关键挑战。为了形式化建模问题,本文首先进行定义:
NL:Natural Language description,指用户或实际业务场景中给出的优化问题文本描述,通常包含目标、资源限制、需求约束和业务背景等信息MF:Mathematical formulation,指不带具体实例数值、抽象和通用的数学建模结构,通常包括集合、参数、变量、目标函数和约束。描述 “某类问题应该如何建模”,而非某个具体实例的数值模型PD:Problem Data,定义为已经填入具体数值,可以调用求解器来获得最优解的某种建模形式。可以是数学表达式、LP/MPS文件或任何其他可直接用于求解器的格式(如 gurobi 代码)。在 OptMATH 框架的不同阶段,作者使用了不同形式的 PD.lp 文件是一种优化模型文件格式,通常由目标函数、约束、变量上下界、整数或二进制变量声明等信息组成,用来把线性规划、整数规划、混合整数规划等模型写成求解器可读的文本。Gurobi、CPLEX、SCIP 等求解器都能读取 .lp 文件。示例如下
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
Maximize
profit: 50 table + 30 chair
Subject To
carpentry_time: 4 table + 3 chair <= 240
painting_time: 2 table + 1 chair <= 100
Bounds
table >= 0
chair >= 0
Generals
table
chair
End
-
OptMATH 可以理解为一个数据飞轮,分为如下图所示的三个阶段:
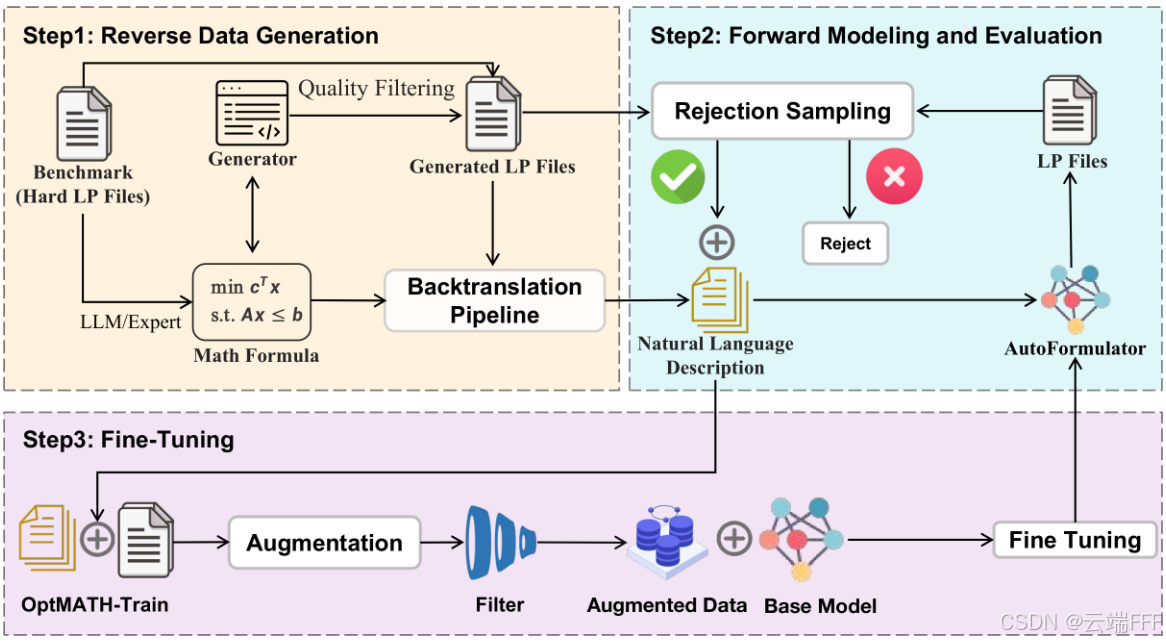
- 逆向数据合成:首先收集 数据对,再使用基于 LLM 的反向翻译方法生成 。其中 均使用 LP 文件形式,数据对来源有两个
- MIPLIB 和 netlib 等具有挑战性 Benchmark 的 LP/MPS 文件
- 超过50个由专家精选的种子问题生成器,涵盖多种优化场景。这些生成器能够生成难度可调控的海量参数化数据
- 前向建模和验证:使用经过训练的 AutoFormulator 将 转换为 (AutoFormulator 直接生成求解器代码,然后导出为 LP 文件)。接下来使用拒绝抽样策略,仅保留原始 与生成 优化目标值完全匹配的实例,保证语义等价性
- 模型微调:对步骤 2 接受的高质量样本进一步使用数据增强策略,包括问题改写、语义替换、约束扩展和数值增强,以提升数据集多样性和覆盖范围,组成 OptMATH-Train 数据集,然后用 SFT 微调基座模型得到 AutoFormulator
- 逆向数据合成:首先收集 数据对,再使用基于 LLM 的反向翻译方法生成 。其中 均使用 LP 文件形式,数据对来源有两个
-
AutoFormulator 专门用于把优化问题的自然语言描述转成数学模型和求解代码,它是一个经过微调的 LLM,其训练目标为:
其中 衡量生成的 是否和原始三元组一致, 是一个将 NL 转化为 MF 和 PD 的建模提示模板
2.1 复杂度可控的 PD 生成
- 整个数据合成框架的核心之一就是生成优化问题实例,也就是生成 问题示例数据。这里不是简单让 LLM 随机编题,而是:
- 人工从各类优化期刊和网站中精选了 50 多个种子问题类别
- 为每类问题写参数化实例生成器 ,其中 可以控制问题的规模和难度,如集合规模、参数范围、变量类型、约束类型和数量等。每个问题生成器对应一类数学建模
- 用反馈机制让 LLM 迭代调整生成器配置,控制生成实例的复杂度、可行性和求解时间,从而得到规模、复杂度和可解性均可控的大规模优化实例
2.1.1 复杂度评估
- 作者给每个问题数据 定义复杂度分数:
- 分别是二元变量、整数变量和连续变量的数量
- 代表线性约束、指示 变量约束、二次约束以及一般非线性约束的数量
- 反映 Big-M 建模结构()出现的频率
- 是目标函数和约束的平均变量项数,用于捕捉表达式的结构信息
- 权重 是可调参数,用于反映各组件对整体复杂度的贡献程度
- 中变量类型、约束类型、Big-M 使用频率和表达式长度都会提高复杂度,这个设计偏向给 “建模负担” 打分,而不是只看题面长度。具体使用时生成器 首先生成 gurobi 代码,然后从代码导出 LP 文件,最后在 LP 文本上计算
2.1.2 基于反馈的复杂度控制
-
作者提出一种反馈式方法来自动调整生成器 的实例化配置参数,以生成符合复杂度、可行性和求解时间要求的 ,如下所示:
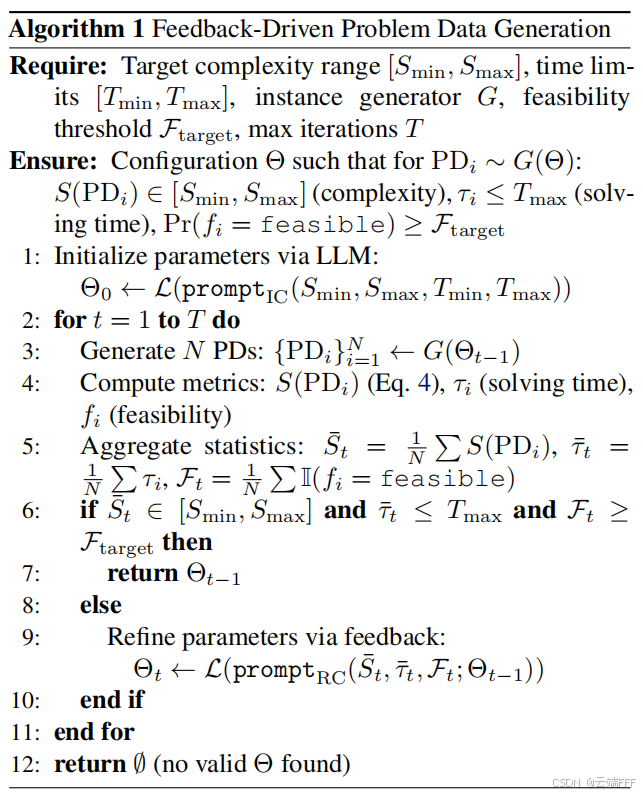
- 首先指定目标的复杂度、求解时间、可行性阈值等边界
- 使用初始化配置的模板 获得初始配置参数
- 使用该配置生成 N 个 ,并通过复杂度评分、求解时间和可行性进行评估。
- 基于这N个生成 的指标统计结果创建反馈 。LLM根据已求解实例的反馈迭代调整参数,最终收敛至满足预定义标准的配置。
-
这里最值得学的是:作者不是直接让 LLM 写最终数据,而是让 LLM 调“数据生成器的参数”。这样数学对象仍由可控生成器和求解器兜底,LLM 负责高层搜索和调参
2.2 双向数据合成框架
2.2.1 双向验证机制
-
本节中所有 都以 gurobi 代码形式存在,双向数据合成算法将问题生成器 对应的抽象数字模型与生成的具体问题教据 转换为经验证样本 ,构成数据集 ,用于训练 AutoFormulator
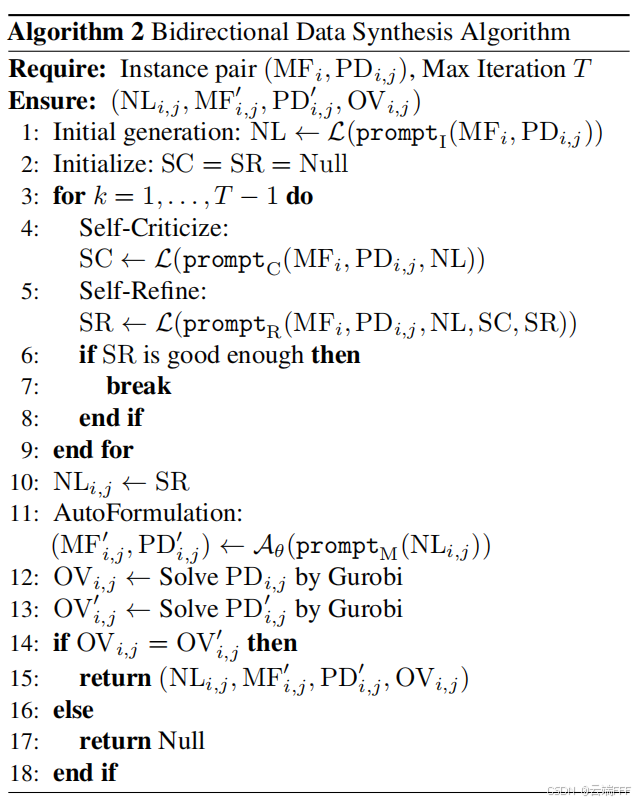
- :用于逆向数据翻译的通用 LLM
- :经过微调的 AutoFormulator 模型
- :用于初始生成反向翻译的 prompt 模板,供 反向翻译 使用
- :用于 Self-Criticism 的 prompt 模板,指导 检验当前描述 与 的数学等价性、约束条件与目标函数的完整性、清晰度与可理解性,以及参数与 的一致性,形成评估意见 。在第 次迭代中,批评SC整合了所有先前迭代的反馈以指导改进
- :用于 Self-Refinement 的 prompt 模板,指导 基于 生成经过优化的描述 。优化过程着重提升数学准确性、约束条件的完整性以及描述的清晰度
- :用于正向建模的 prompt 模板,供 正向建模使用
- :第 类问题,对应通用数学建模 和生成器
- :某类问题下的第 个问题实例,对应问题数据 和通用数学建模 (记为 )
- 是问题实例 的自然语言描述,由算法输入 经 反向翻译初始化,再进行多轮自我评估和自我优化得到
- 是使用 对反向翻译的 正向建模得到的通用数学模型和问题实例
- 分别是求解 定义的问题所获得的最优值,二者相等则验证数据语义等价,可以进行输出
-
这套 “反向翻译 + 前向建模 + 拒绝采样” 的流程可以概括为
主要分成两个阶段验证 三元组的语义对齐
- 通过 Self-Criticism 和 Self-Refinement 提升反向翻译的 和原始 的一致性
- 通过验证求解结果 相等,验证问题实例 的等价性
-
需要注意的是
- 这里所谓的 “语义等价” 不是严格数学等价,而是最优值一致性,算法2本质上验证的是:由原始****反向翻译的 ,经过 AutoFormulator 前向建模后得到的 是否与原始 在求解意义上保持一致,其中直接验证对象是 的最优目标值的一致性
- 求解结果一致不能保证优化问题相同,因此 OptMATH 的 rejection sampling 并不是严格的语义等价验证,而是一种基于求解结果的弱监督质量过滤机制。它通过最优值一致性近似判断 NL、MF、PD 是否对齐,能够有效过滤大量明显错误样本,但不能排除不同模型偶然具有相同最优值、非绑定约束被遗漏、变量语义偏移等问题。该方法更适合作为大规模数据合成中的高效启发式筛选,而不是严格的数学模型等价判定。作者也承认这是开放问题,但他们用 LLM-committee 和人工抽样检查 1% 数据,得到 99.6% 的三元组等价准确率。换句话说,最优值匹配是一个便宜但不完美的代理信号
2.2.2 反向翻译
-
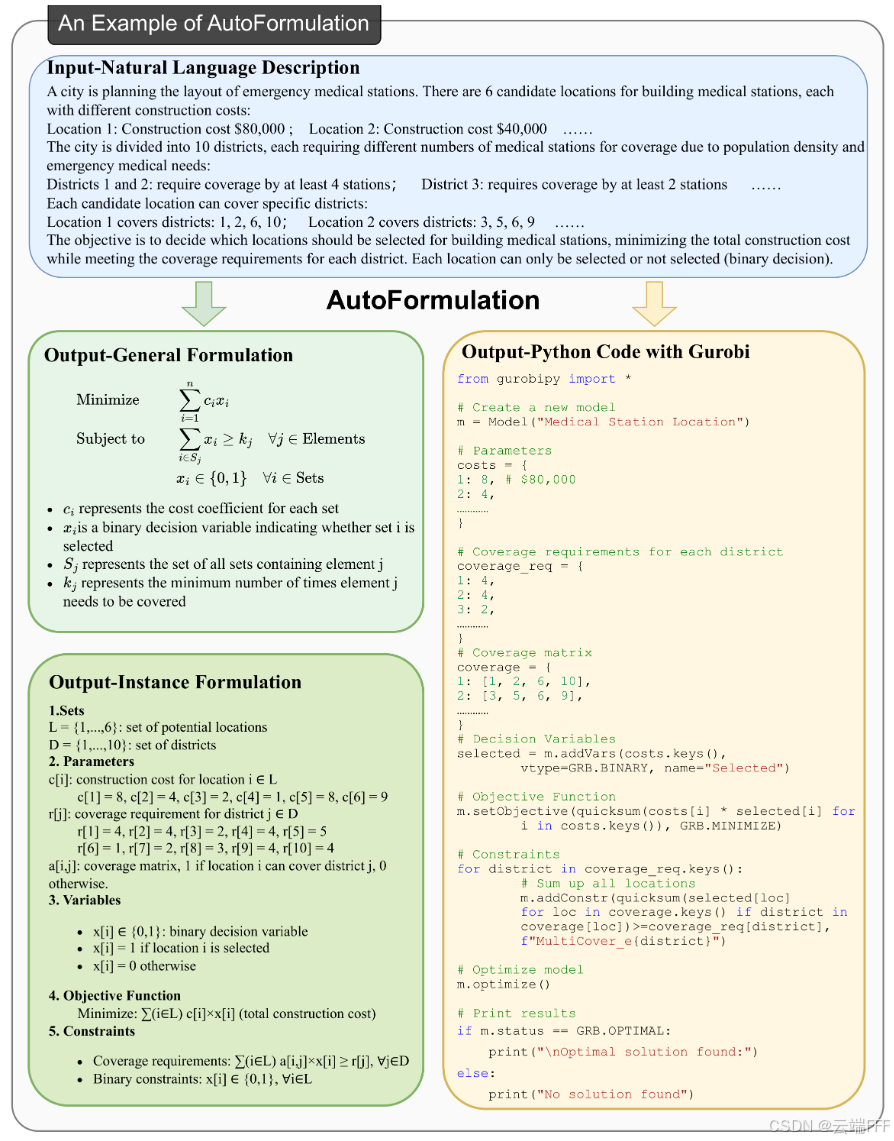
聚焦于算法 2 中第一步使用 的反向翻译环节,其输入不是空白提示,而是一般数学公式和具体的 LP 文件。LLM 需要把集合、参数、约束和数值解释成业务语境中的题面,例如医疗站选址、生产排程、供应链调度等,如下图所示
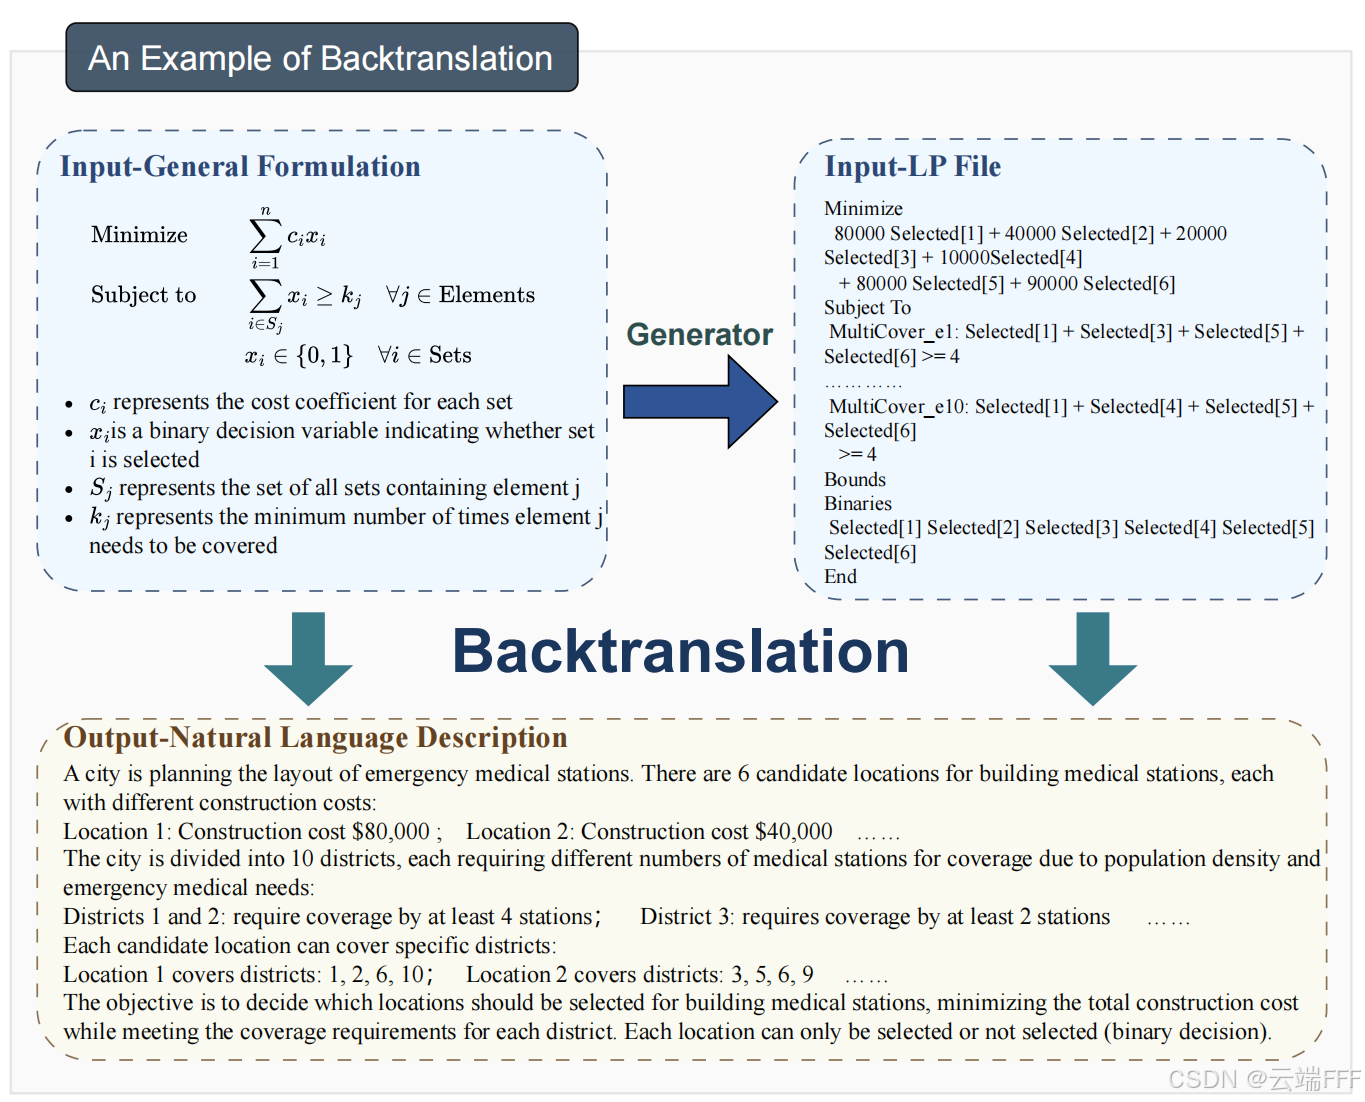
- 左上是经过算法 1 调优生成参数的 类问题生成器,它对应一类通用数学建模
- 右上从生成器采样生成的问题实例 ,以 LP 文件形式存在
- 下方是经过翻译的自然语言题面 :把 “Selected[1] + Selected[3] + ... >= 4” 翻译成“某地区至少需要 4 个医疗站覆盖”
-
在翻译流程中,作者使用 Deepseek-V3 作为基础模型 ,为提升翻译得到题面的多样性
- 并将温度参数设置为 0.8 以增强多样性
- 在初始生成阶段实现了随机场景分配机制,该机制引导大语言模型合成能够最优融合数学特征与指定场景的问题
参考代码,系统先从预设的应用场景池(供应链、金融、制造、交通、医疗)中随机抽取一个场景,然后将该场景与当前 PD 的数学表达式和 LP 数据一同注入提示词中,要求大语言模型在保持数学结构等价的前提下,把变量、约束和目标函数重新解释为符合该场景语义的自然语言问题。生成后,系统还会通过 critique/refinement 流程检查自然语言描述是否与原始 LP 数据一致,并在发现不一致时继续修正。因此,这里的 “融合数学特征与指定场景” 是通过 “随机场景采样 + 强约束提示词 + 一致性校验与迭代修正” 的组合来实现,从而让同一类数学结构能够被包装成多样化的真实应用问题
2.2.3 OptMATH-Train 数据集
-
数据构造概述如下
-
通过反向翻译流程生成了约12万个易于优化的问题,大多数问题的字符数在2,000至5,000之间
-
应用拒绝抽样法后约 40% 的生成问题被剔除。过滤前后的问题长度分布保持了相似的特征,说明基于最优值相等的质量控制流程能有效去除低质量样本,且不会引入长度相关偏差,从而确保保留的问题具有自然合理的描述长度
-
经过包含语义验证和难度校准在内的多阶段优化后,最终流程生成了15万个经过严格验证的优化问题。其中有10万个原始问题,5万个在原始问题上的增强实例,构成 OptMATH-Train 数据集。其场景和序列长度分布如下
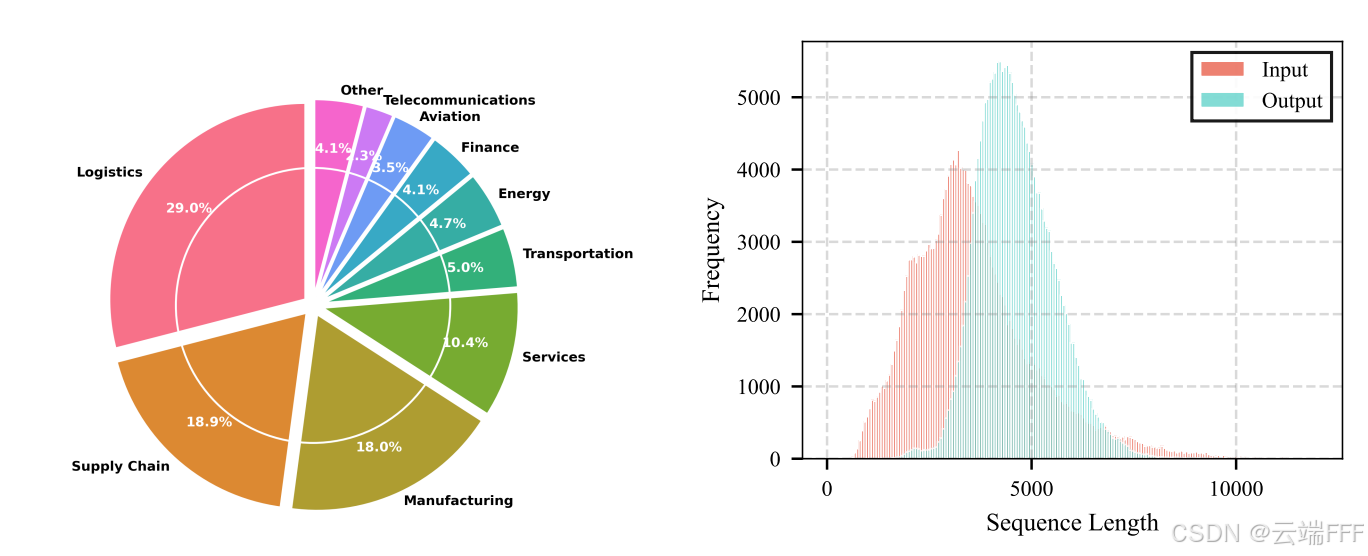
- 高频场景包括 Logistics 29.0%,Supply Chain 18.9%,Manufacturing 18.0%。这和真实 OR 应用常见领域一致,但也意味着模型可能对这些高频领域更熟悉。
- 小众场景如 Finance、Aviation、Telecommunications 仍有覆盖,但占比明显低。
- Self-refine 实验显示,算法2的迭代次数设置为 T=1 即可在接受率和 token 成本之间取得较好折中
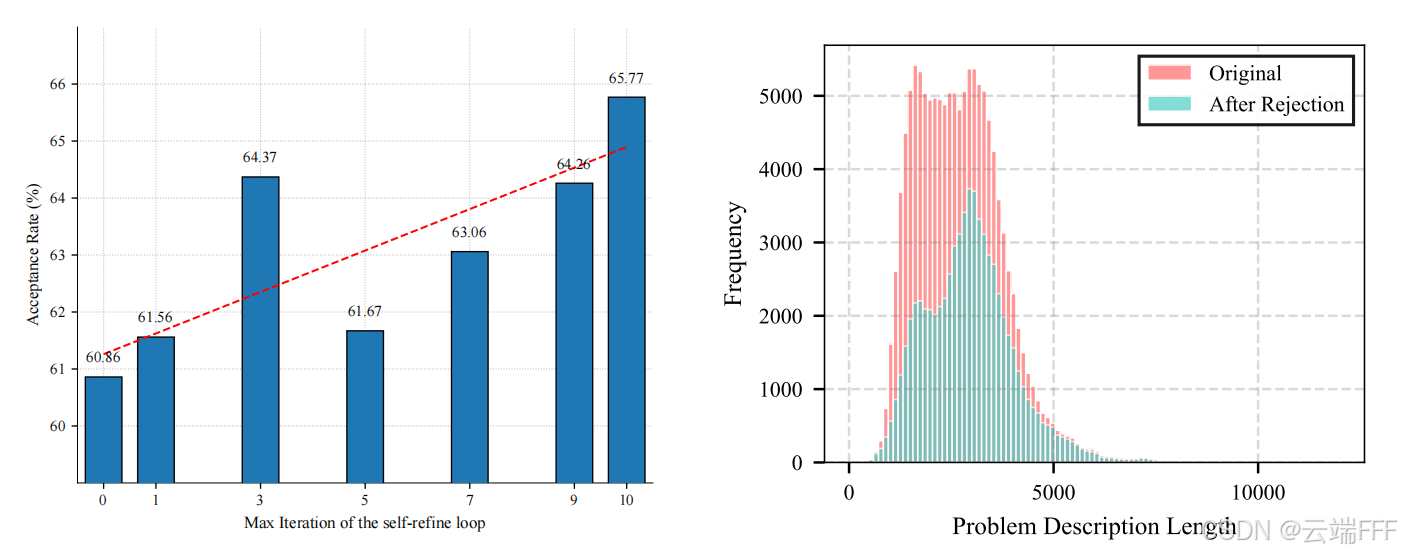
- 直接生成(T=0)的接受率约 60.86%,加入一次 self-refine 后到 61.56%
- 更大的迭代数不单调提升(T=10)最高约 65.77%,但成本也更高
- 右图说明拒绝采样前后的题面长度分布形态相似,过滤过程没有明显偏向短题或长题
-
-
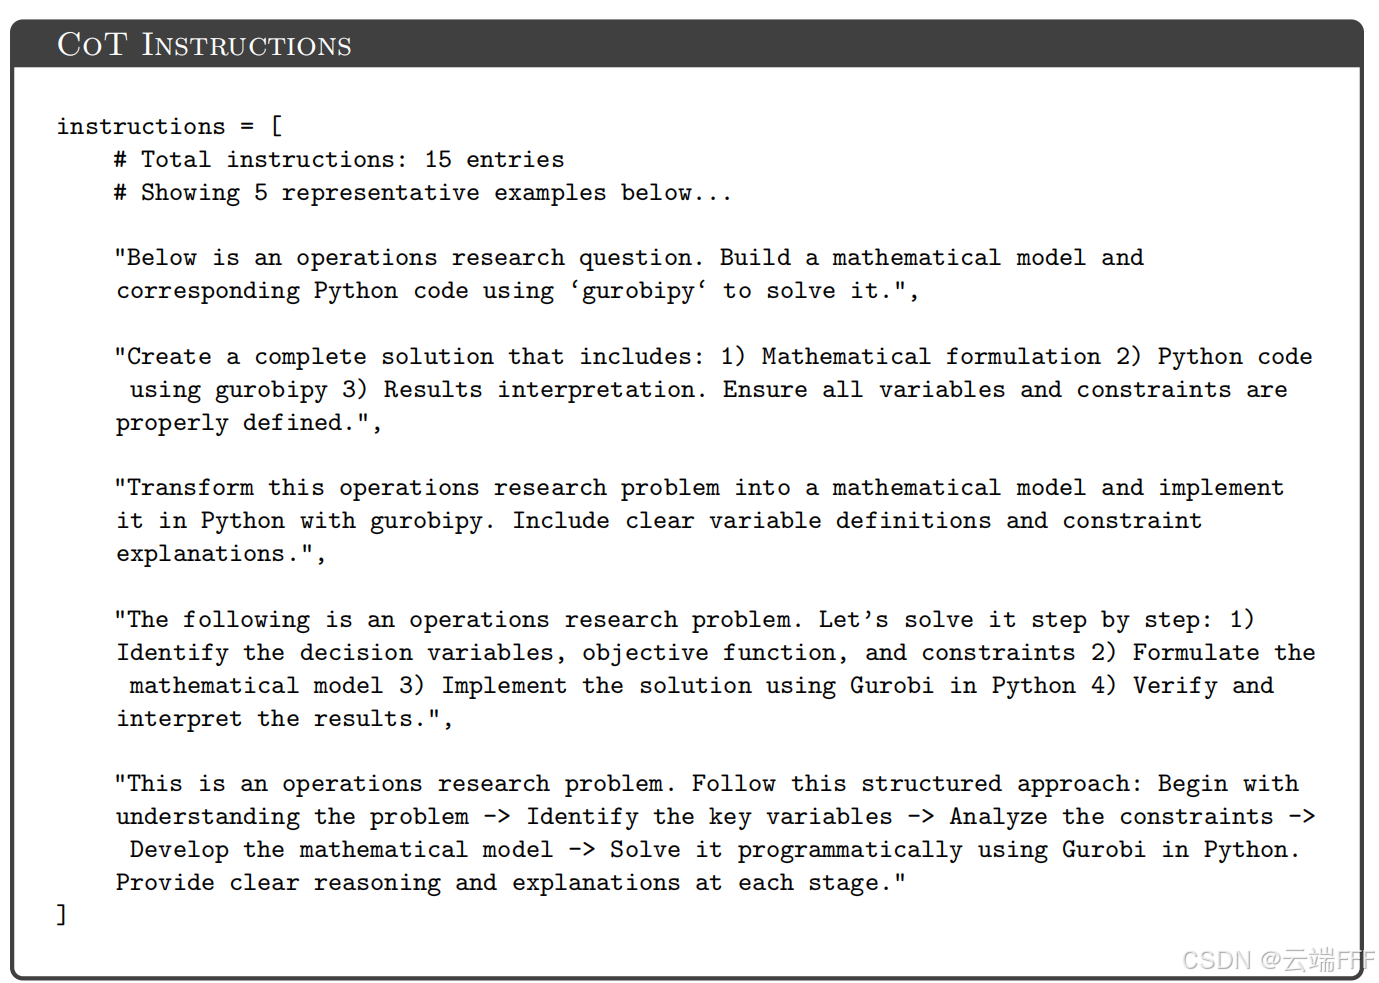
作者在附录 D.1 提到:为了提升 AutoFormulator 的建模能力,作者设置了 15 种不同的 CoT 提示,这些指令在分解方法、中间推理步骤和呈现格式上各具特色,为问题建模提供了多种路径,以确保数据集涵盖广泛的有效数学建模方法,并保持逻辑连贯和数学正确性
代码仓库中没有包含这部分数据合成的细节,我的理解是:算法2构造的样本 中, 都是从 建模得到的,作者是在第一步构造初始 NL 时随机应用了不同的 CoT,从而得到了不同的 MF 和 PD 形式,并在后续 self-refine 过程中通过提示初始 NL 保持其风格,最终不同的推理风格被融合进 MF 中,并在 SFT 时统一教给基座模型。部分 CoT 提示示例如下:
以下例子展示了指令集中的一种典型建模范式,该格式包含三个关键组成部分:采用标准符号表示的通用数学模型、包含完整参数定义的实例化详细模型,以及基于Gurobi的Python实现代码
2.3 模型微调
2.3.1 数据增强
-
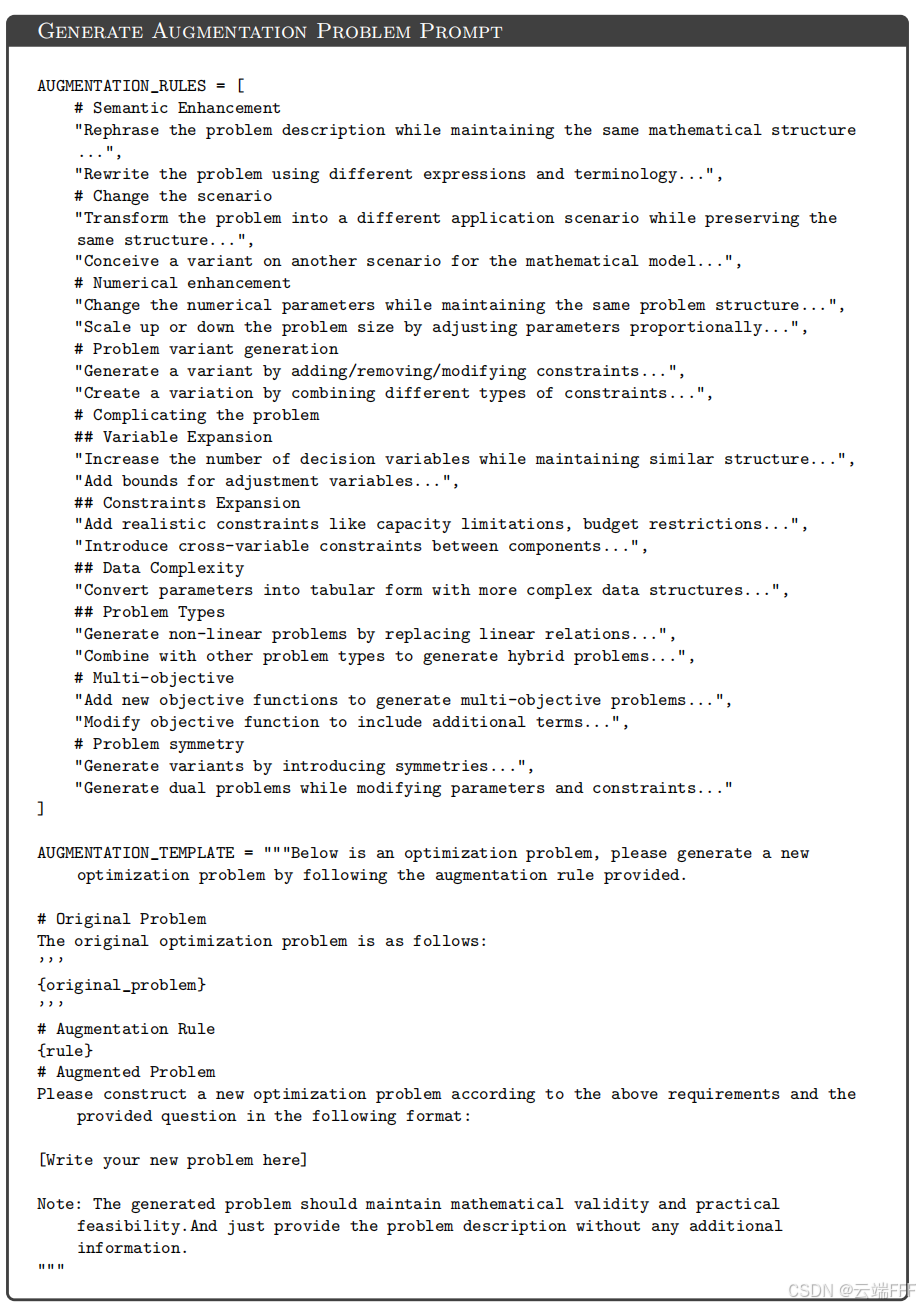
数据增强用于提升训练集多样性,对于每个数据实例,系统会随机选取规则引导 LLM 生成增强结果
-
为进行质量控制,作者使用 LLM 对每个增强规则进行两次独立采样,随后应用 2.2.1 节所述的基于最优值相等的拒绝采样策略。预置的数据增强规则包括包括问题重写、语义替换、约束扩展和数值增强等,如下所示:
-
平均每个问题经数据增强可生成 10 个有效增强版本,有效补足了非标准表达和困难题
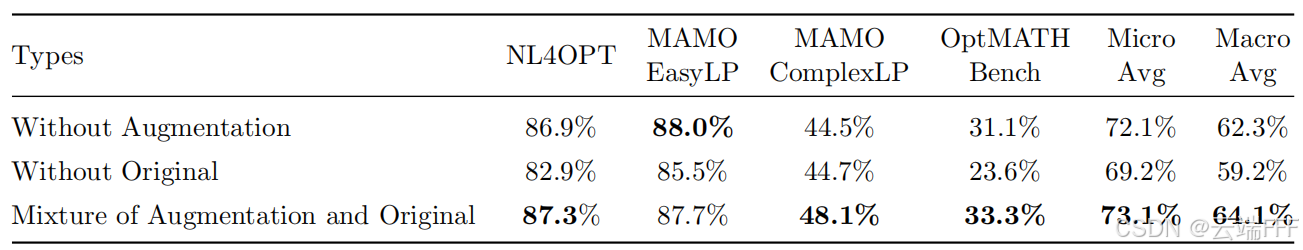
- 只用原始数据在 NL4OPT 和 MAMO EasyLP 上更强,说明简单线性题更吃干净的标准样本
- 只用增强数据在 MAMO ComplexLP 上略强于不增强,说明非标准表达对难题有帮助
- 原始 + 增强混合在 OptMATH-Bench、Micro Avg、Macro Avg 上最好,Macro Avg 从 62.3% 提升到 64.1%
2.3.2 训练 AutoFormulator
- 作者使用 OptMATH-Train 数据集 对 Qwen2.5(0.5B~32B)基座模型进行 LoRA SFT,训练模型能够根据问题描述 生成数学建模和求解代码的拼接 ;
- SFT 使用标准序列预测损失
该方法使模型能够在统一的序列到序列框架内,学习从自然语言问题描述到数学公式及求解器代码之间的映射关系
3. 实验
3.1 实验设定
- 数据集:作者评估了五组 Benchmark:
NL4OPT、MAMO EasyLP、MAMO ComplexLP、IndustryOR、OptiBench和自建OptMATH-Bench其中 NL4OPT 原始没有 ground truth,作者用 LLM 生成初始答案后由专家校正;OptiBench 也需要抽取最优值作为 golden answer。
- 评价指标:
pass@1 accuracy,即模型生成的代码运行后得到的最优值匹配 ground truth 的精度。附录中的相对误差判断为: - Baselines:Llama3.1-8B、Qwen2.5-7B、Qwen2.5-32B、GPT-3.5-turbo、GPT-4、DeepSeek-V3、OptiMUS、ORLM-Llama-3-8B 等
作者还报告了 OptMATH 微调模型的 pass@8,上限能力明显更高。
- 训练设置:主实验使用 LLaMAFactory 做 SFT,基础模型覆盖 Qwen2.5 0.5B 到 32B;LoRA rank 32、alpha 32、dropout 0.1,学习率大体为 ,训练 1-3 epoch。模型规模消融由于算力限制使用 100k 训练样本
3.2 实验结果与分析
3.2.1 数据规模和难度:OptMATH 是否真的覆盖更广、更难?
-
作者利用生成器生成了经过质量筛选的数据集,包含超过 600,000 个 LP 文件,涵盖 53 种不同的问题类型和 5 个难度等级上
53 个问题生成器,每个进行 5 档难度调参
生成 LP 文件的长度分布如下
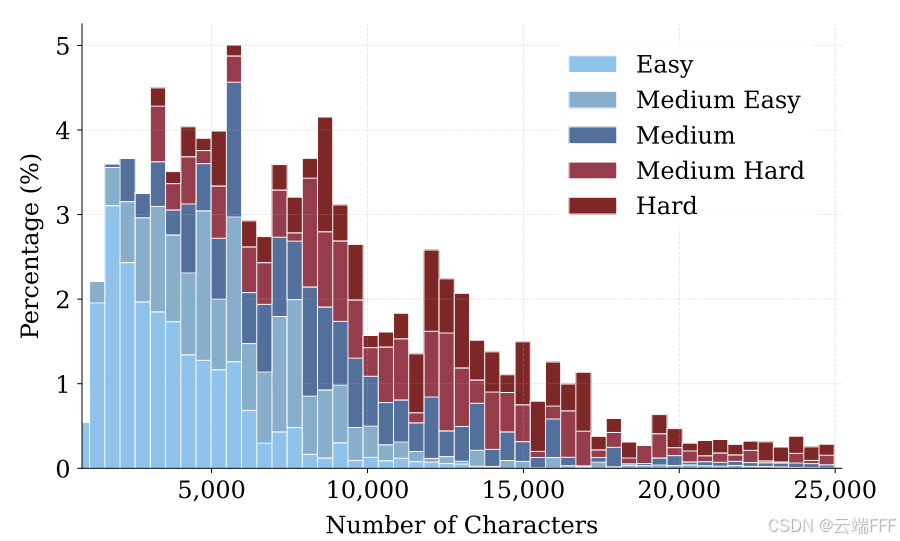
- 生成 LP 文件长度覆盖 1k 到 25k 字符,难度分层从 Easy 到 Hard 都有样本
- 不同长度的比例分布均衡,集中于中等难度级别
-
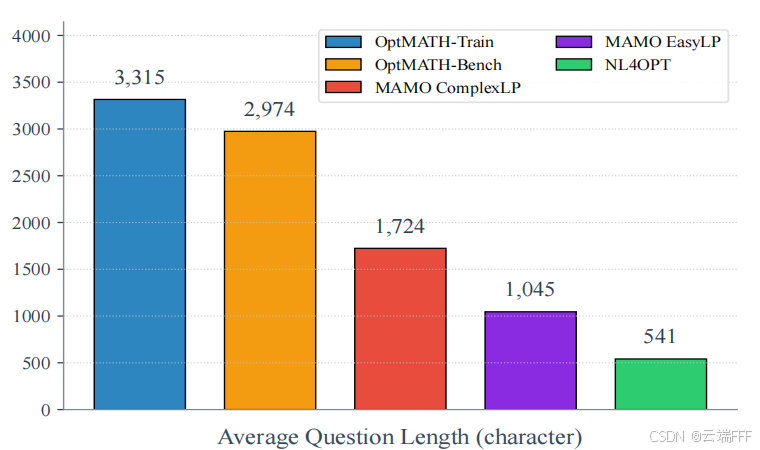
和现有 Benchmark 相比,OptiMATH 的问题描述更长,复杂度显著更高
-
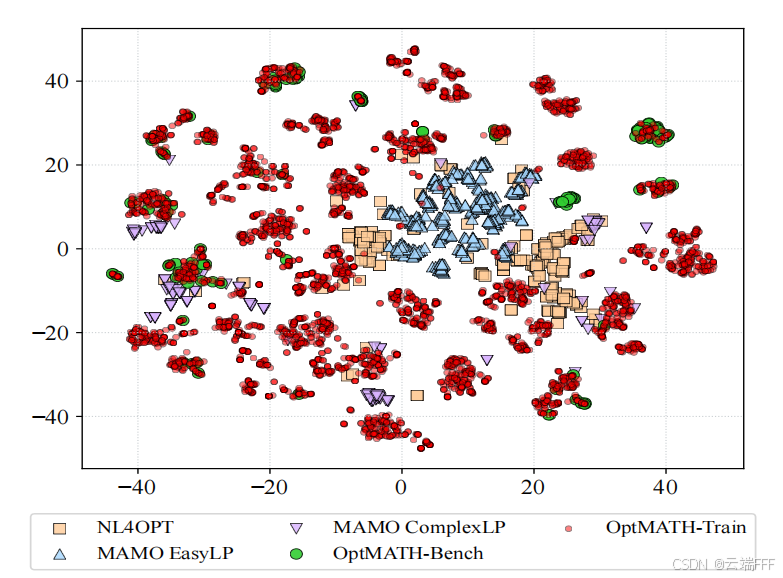
t-SNE 可视化显示 OptMATH-Train 围绕其他 Benchmark 分布,作者据此认为它覆盖了更多问题族
3.2.2 主结果:OptMATH 微调是否提升建模能力?
-
实验设定:在五个 Benchmark 上比较基础模型、闭源强模型、OptiMUS/ORLM,以及用 OptMATH-Train 微调后的模型;核心指标为 pass@1,另报告 pass@8
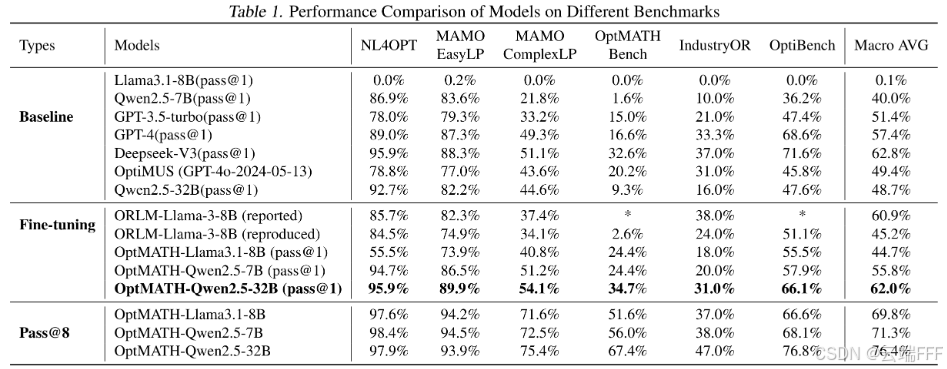
- OptMATH-Qwen2.5-32B pass@1 的 Macro Avg 为 62.0%,接近 DeepSeek-V3 的 62.8%,并超过 GPT-4 的 57.4%
- OptMATH-Qwen2.5-7B 的 Macro Avg 为 55.8%,高于复现 ORLM-Llama-3-8B 的 45.2%,也高于 OptiMUS 的 49.4%
- 在最难的 OptMATH-Bench 上,OptMATH-Qwen2.5-32B pass@1 为 34.7%,pass@8 可到 67.4%,说明多采样/后续 RL 或 reranking 仍有很大空间
- Llama3.1-8B 基础模型几乎不会建模,但微调后 Macro Avg 到 44.7%,说明数据对弱基础模型也有显著迁移价值
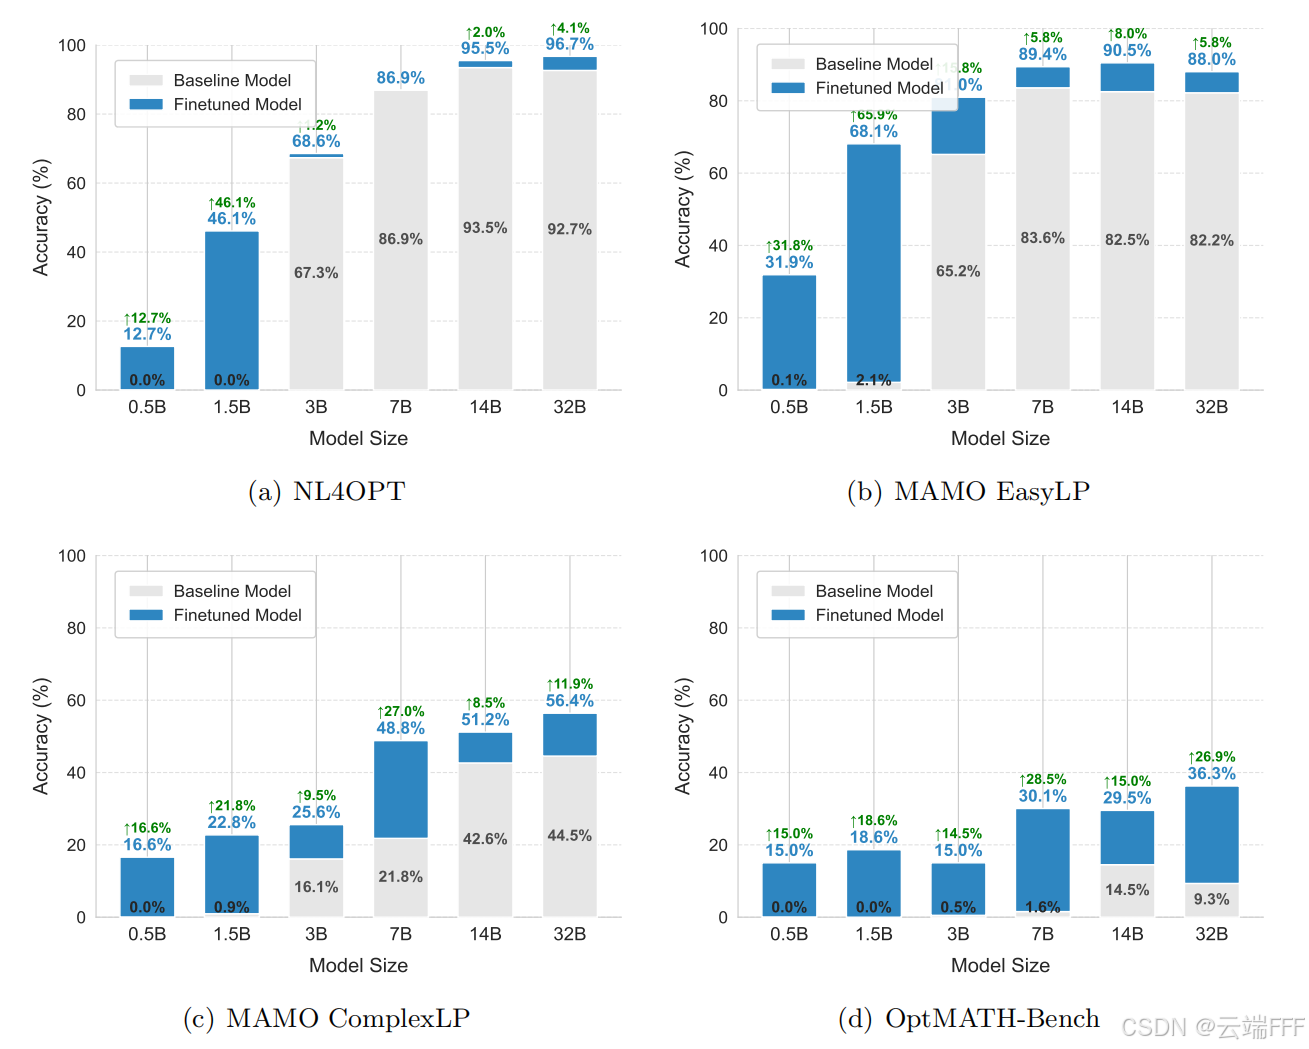
3.2.3 模型规模与数据规模:收益在哪里饱和?
-
实验设定:用 Qwen2.5 0.5B-32B 观察模型规模变化,并用 Qwen2.5-1.5B 观察一个 epoch 内不同训练数据比例的效果
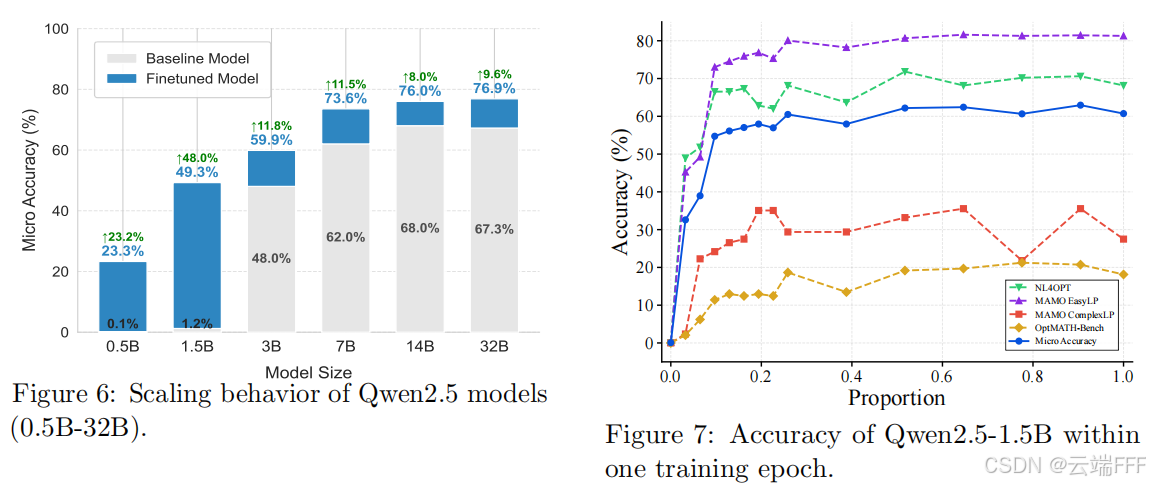
- 模型规模越大,绝对性能一般越高,但微调增益呈递减趋势
- 小模型的相对增益很大,例如 0.5B 从接近 0 到 23.3% Micro Accuracy
- 数据比例曲线显示,少量 OptMATH-Train 已能带来明显提升,后半段更多是细调而非跃迁。
-
附录给出更细表格。这里能看到不同 Benchmark 的真实差异:简单集上大模型本身已经强,复杂集上微调更关键
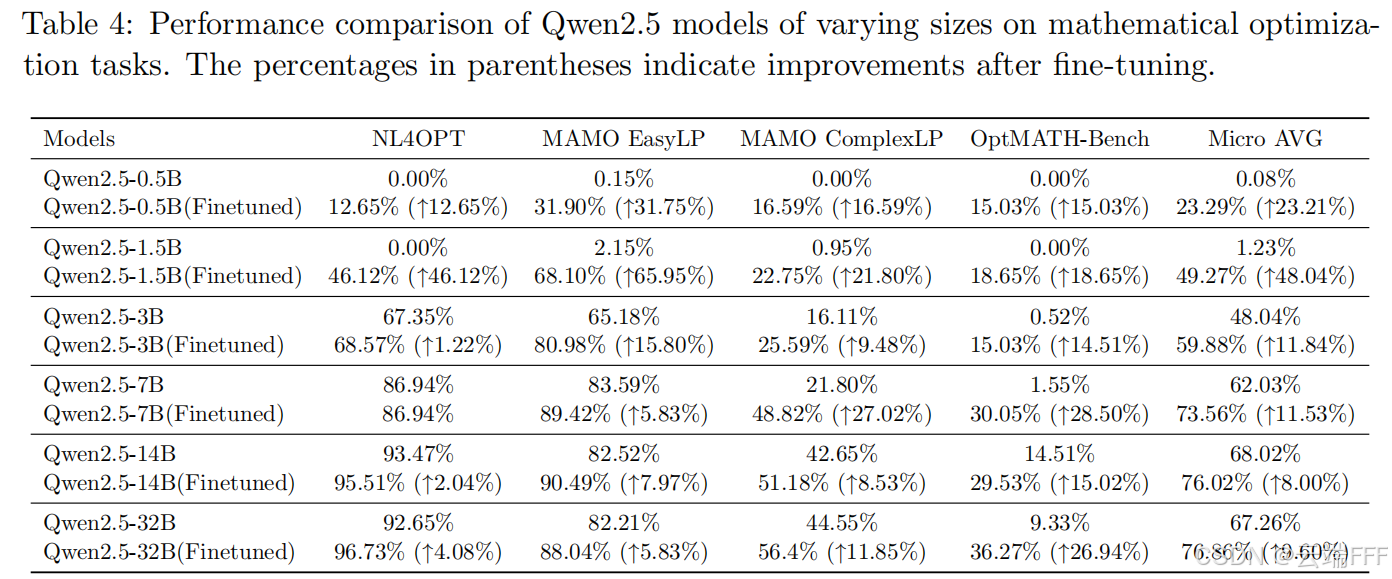
- NL4OPT 上 7B 基础模型已到 86.94%,微调没有提升;这说明简单 Benchmark 已接近饱和,不适合作为唯一评价
- Qwen2.5-7B 在 MAMO ComplexLP 上从 21.80% 提升到 48.82%,增益 27.02 个点
- Qwen2.5-32B 在 OptMATH-Bench 上从 9.33% 提升到 36.27%,增益 26.94 个点。
-
多个 Benchmark 上的规模扩展结果:在 OptMATH-Bench 上 等困难评估集上,即使用 14B/32B 并经过微调,准确率仍远低于简单 Benchmark。这说明 OptMATH 并没有把优化建模“解决掉”,只是把模型从不会建模推到一个可用但仍脆弱的区间
4. 代码分析
4.1 伪代码
- 官方仓库包含端到端数据生成、backtranslation、forward modeling、evaluation 和 seed generators;论文中大规模 SFT 主要依赖 LLaMAFactory,仓库没有完整训练代码。因此下面伪代码是基于论文算法和仓库流水线的简化重构:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
def build_optmath_dataset(generators, autoformulator, llm, target_ranges):
accepted = []
for generator in generators:
# 1. 通过复杂度区间选择生成器参数,目的是控制变量数、约束数、Big-M 等建模负担。
theta = select_config_with_feedback(generator, target_ranges)
for pd in generator.sample(theta):
# 2. 先用求解器验证原始 PD 可行且有最优值,否则后续最优值匹配没有参照。
ov = solve_with_gurobi(pd)
if ov is None:
continue
# 3. 反向翻译:把数学公式和 LP 文件变成自然语言题面。
nl = llm.generate(prompt_initial(mf=pd.formula, pd=pd.lp_text))
critique = llm.generate(prompt_criticize(nl, pd.lp_text))
nl = llm.generate(prompt_refine(nl, critique, pd.lp_text))
# 4. 正向建模:AutoFormulator 从题面重新生成公式和 Gurobi 代码。
mf_prime, pd_prime = autoformulator.generate(nl)
ov_prime = solve_with_gurobi(pd_prime)
# 5. 拒绝采样:只有最优值一致的样本进入训练集。
if is_same_objective_value(ov, ov_prime):
accepted.append((nl, mf_prime, pd_prime, ov))
# 6. 对部分样本做问题重写、语义替换、约束扩展等增强,再重复验证。
augmented = verified_augmentation(accepted)
return accepted + augmented
4.2 工程技巧
-
复杂度过滤不要只看样本数量,而要把变量、约束和表达式结构显式打分。 仓库的
optmath/generators/complexity.py把论文公式落成ComplexityScorer,虽然 LP 文本解析是启发式的,但工程上已经把“题有多难”从主观判断变成可调指标。1
2
3
4
5
6
7
8
9
10
11
12
13# optmath/generators/complexity.py
score = (
self.weights.alpha_bin * metrics.num_binary +
self.weights.alpha_int * metrics.num_integer +
self.weights.alpha_cont * metrics.num_continuous +
self.weights.beta_lin * metrics.num_linear +
self.weights.beta_indic * metrics.num_indicator +
self.weights.beta_quad * metrics.num_quadratic +
self.weights.beta_gen * metrics.num_general +
# 中文注释:Big-M 和表达式长度单独计分,因为它们常对应更难的建模技巧。
self.weights.gamma_bigm * metrics.bigm_frequency * 100 +
self.weights.delta_expr * metrics.avg_expr_length
) -
生成器阶段先求解,再保存 LP,这能把不可行和超时样本挡在数据集外。
optmath/generators/pipeline.py会限制变量/约束数量,调用 Gurobi,只有OPTIMAL的实例才写入训练候选。1
2
3
4
5
6
7
8
9
10
11
12
13# optmath/generators/pipeline.py
model.Params.TimeLimit = 5.0
model.Params.OutputFlag = 0
model.optimize()
status = status_map.get(model.Status, "UNKNOWN")
obj_val = model.ObjVal if model.Status == 2 else None
# 中文注释:只保留有确定最优值的样本,后面才能做 OV 一致性验证。
if status != "OPTIMAL":
continue
model.write(str(lp_path))
lp_content = lp_path.read_text() -
Backtranslation 不是单次生成,而是 generate -> criticize -> refine 的可并发流水线。
optmath/backtranslation/pipeline.py把场景随机化、token usage 记录、失败 fallback 和多线程处理放在一起,比较适合跑大量样本。1
2
3
4
5
6
7
8
9
10
11
12
13
14# optmath/backtranslation/pipeline.py
scenario = random.choice(APPLICATION_DOMAINS)
prompt = GENERATE_PROMPT.render(
mathematical_expression=instance.mathematical_expression,
lp_data=instance.lp_data,
scenario=scenario,
examples=DEFAULT_EXAMPLES,
)
content, usage = self.llm.complete(...)
instance.problem_description = content
# 中文注释:如果 critic 判定 Complete Instance,就提前停止,节省 refinement token。
if "Complete Instance" in (crit_content or ""):
break -
Forward modeling 的输出格式被强约束为 Gurobi 代码,便于后续自动执行。
optmath/modeling/pipeline.py的 prompt 要求代码块、model变量、<=约束和print(model.objVal),这些规则是为了降低执行解析成本。1
2
3
4
5
6
7
8
9
10
11# optmath/modeling/pipeline.py
COT_PROMPT_TEMPLATE = """
Below is an operations research question. Build a mathematical model
and corresponding python code using `gurobipy`.
...
1. Output ONLY the Python code within a ```python code block
2. Start your code with: import gurobipy as gp
3. Name your model variable as `model`
...
"""
# 中文注释:把输出协议写死,可以让 eval/executor.py 稳定提取并运行代码。 -
Evaluation 里有 conversion fallback,反映了优化题评测的半开放性。
eval/executor.py会在原始代码错误时尝试变量类型、严格不等式、目标方向的替换;这不应理解为模型本身一定写对了,而是为了公平处理题面中的整数/连续歧义和格式差异。1
2
3
4
5
6
7
8
9
10
11
12
13# eval/executor.py
for modifier, args in [
(self._convert_variable_type, (True,)),
(self._convert_variable_type, (False,)),
(lambda s: self._convert_inequality(s), ()),
(lambda s: self._convert_objective(s, True), ()),
(lambda s: self._convert_objective(s, False), ()),
]:
mod_script = modifier(script, *args) if args else modifier(script)
# 中文注释:只有转换后的代码得到正确最优值,才标记 conversion_improved。
if new_result["judge"]:
new_result["conversion_improved"] = True
return new_result
5. 总结
5.1 创新思想来源
- OptMATH 的核心创新不是 “又造了一个数据集”,而是紧密融合了三个已有思想:
- OR 领域本来就有可求解的 LP/MPS 文件和问题生成器;
- LLM 可以把结构化数学对象反向写成自然语言;
- 求解器可以提供最优值这个低成本、可规模化的验证信号。
- 这个组合的妙处是,数据合成不再完全依赖人工标注,也不完全信任 LLM 自己生成的内容
- 专家生成器负责数学结构
- LLM 负责语义表达和参数调节
- 求解器负责可执行验证
5.2 Review意见
- Program Chairs 的决定意见可以概括为:OptMATH 的双向数据合成思路有意思,能缓解优化建模数据短缺,实验显示合成数据对 LLM 建模能力有帮助;但所有评审都是偏正面的弱支持,并没有强力支持
- 审稿人认可的点主要集中在三处:
- 问题重要:优化建模缺少高质量训练数据,OptMATH 把 OR 生成器、反向翻译、正向验证接成闭环,确实切中数据稀缺问题。
- 框架完整:多位 reviewer 认可 rejection sampling、可控复杂度、OptMATH-Train 和 OptMATH-Bench 的整体设计,认为实验覆盖了 NL4OPT、MAMO、OptMATH-Bench 等必要基准
- 实验有效:评审普遍接受“用 OptMATH 训练后模型效果提升”这个主张,尤其注意到 finetuned Qwen 系列在多个 benchmark 上明显优于未微调版本
- 主要质疑也很集中:
- Benchmark 与训练数据是否足够独立:Reviewer LZQX 明确担心 OptMATH-Bench 和训练数据生成流程相似,可能更多反映 in-domain 能力,而不是真正泛化
- 被拒绝样本如何整理成 Benchmark 讲得不够细:评审要求作者解释 rejected data 如何被进一步筛选、专家如何验证、和训练集有什么分布差异
- 复杂度可控机制需要更透明:Reviewer LZQX 误以为作者训练了 generator,说明论文对“不是训练生成器,而是调参生成器”的表述不够清楚。
- 泛化和规模问题:Reviewer PCa3 认为 LP 文件可能非常大,LLM 分析大规模实例会遇到上下文长度和计算成本瓶颈;Reviewer WcAc 也担心 seed data 覆盖范围限制模型迁移到新领域
- 实验补充需求:评审要求加入 LLaMA 系列、IndustryOR / ComplexOR / OptiBench 等更硬或更外部分布的结果,并补充 Chain-of-Experts / OptiMUS 的对比
- 作者 rebuttal 的核心回应是:
- 关于 Benchmark 独立性:OptMATH-Bench 有两条路径,一条来自 AutoFormulator 拒绝样本再经 LLM committee 和 OR 专家验证,另一条来自外部 OR 文献中的困难问题;作者强调它不是简单从训练分布抽样
- 关于复杂度控制:作者澄清并没有训练 generator,而是使用预定义参数化生成器,通过 LLM feedback 调整变量数、约束数、求解时间、可行率等参数
- 关于泛化实验:作者在 rebuttal 中补充 IndustryOR 和 OptiBench 结果,并加入 LLaMA / Qwen baseline、pass@1 和 pass@8,说明微调模型在外部 benchmark 上仍有提升
- 关于语义等价验证:作者承认最优值一致不是严格的模型等价证明,但强调 rejection sampling 加 1% 人工检查得到 99.6% 准确率,实践上足够支撑数据质量
- 关于大模型收益变小:作者把后续提升方向归因到数据增强和多样化 CoT,认为多 formulation 风格可以缓解大模型微调收益递减
- 这组 review 反而很好地指出了 OptMATH 最关键的评价边界:它不是在证明最优值一致等价于语义完全一致,而是在工程上把“可运行、可求解、可大规模过滤”的信号推到足够好。真正需要后续工作的地方,是更强的等价性验证、更独立的外部分布 benchmark,以及更透明的训练数据构造记录
5.3 未来展望
- 更强的等价性验证:最优值匹配可以扩展为多实例扰动、多目标/约束检查、dual certificate、symbolic comparison 或 unit-test 风格的约束覆盖。
- 从 SFT 走向 verifier-guided RL:pass@8 远高于 pass@1,说明候选空间里常有正确模型。下一步可以训练 reranker 或用求解器反馈做 RL,把采样上限转化为单次输出能力。
- Benchmark 防泄漏和反模板化:合成数据很容易留下生成器风格。后续需要更强的去模板化、跨领域真实案例和人工难题,避免模型学会“生成器方言”而非优化建模。
- 更细粒度错误分析:目前结果主要按数据集和规模报告。对建模任务来说,变量类型错误、漏约束、目标方向错误、Big-M 错误、索引集合错误是不同失败模式,应该分开分析。
5.4 Q&A
- Q1:为什么不直接让 LLM 从自然语言生成更多自然语言题?
A:那样缺少可靠 ground truth。OptMATH 从 (MF/PD) 出发,天然有求解器最优值,可以闭环验证。 - Q2:最优值一样就一定是同一个模型吗?
A:不一定。不同约束系统可能碰巧有相同最优值,所以这是实用验收标准而非严格证明。作者用抽样人工检查补强可信度。 - Q3:OptMATH-Bench 为什么更难?
A:一方面题面更长,平均约 2974 字符;另一方面包含 LP、MILP、IP、NLP、SOCP 等更广问题类型,还混入 AutoFormulator 曾经失败的困难样本。 - Q4:这篇论文对实际建模工具有什么启发?
A:真正有价值的是“生成-执行-验证”的闭环。实际系统不应只看模型输出的文字是否像公式,而应尽量把输出变成可运行代码,再用求解器、测试或业务规则验证。 - Q5:最大限制是什么?
A:我觉得是验证信号仍偏粗。最优值正确但约束语义错误的情况依然可能存在;同时 Gurobi/API/训练算力要求也让完整复现成本不低。