论文理解【LLM-Agent】——【SkillOpt】Executive Strategy for Self-Evolving Agent Skills
本文初稿使用 PaperReading-skill 生成。给定论文标题、链接、arXiv/OpenReview 页面、DOI 或本地 PDF,让 Codex 自动完成论文检索、PDF 下载、图表抽取、代码仓库分析,并生成一份适合 Typora 阅读和后续整理的中文论文解读 Markdown 和 PDF,欢迎试用!
- 首发链接:论文理解【LLM-Agent】——【SkillOpt】Executive Strategy for Self-Evolving Agent Skills
- 文章链接:SkillOpt: Executive Strategy for Self-Evolving Agent Skills
- 作者:Yifan Yang, Ziyang Gong, Weiquan Huang, Qihao Yang, Ziwei Zhou, Zisu Huang, Yan Li, Xuemei Gao, Qi Dai, Bei Liu, Kai Qiu, Yuqing Yang, Dongdong Chen, Xue Yang, Chong Luo
- 机构:Microsoft, Shanghai Jiao Tong University, Tongji University, Fudan University
- 代码:microsoft/SkillOpt
- 项目页:SkillOpt
- OpenReview:未找到公开记录
- 发表:arXiv:2605.23904v2,2026-05-25。本文使用 arXiv 当前最新公开版本 v2。
- 领域:Agent Skill Optimization / LLM Agent
- 一句话总结:SkillOpt 把 agent skill 文档当成冻结模型的外部可训练状态,用 rollout 轨迹、受限文本编辑、验证集 gate、拒绝编辑缓存和 epoch 级 slow/meta update,让 “写 skill” 变成一个更像深度学习优化器的可控训练过程
- 摘要:当前 agent skills 通常由人工编写、一次性生成,或通过松散控制的自我修订进行演化;这些方法都不像面向 skill 的深度学习优化器,也都不能在反馈下可靠地超过其初始版本。我们认为,skill 应当被视为 frozen agent 的外部状态来训练,并采用模型权重空间优化的同等规范。SkillOpt 据我们所知是第一个用于 agent skills 的系统性、可控文本空间优化器:一个独立的优化器模型将带分数的 rollouts 转化为对单个 skill document 的有界 add/delete/replace 编辑,并且只有当某个编辑严格提升 held-out validation score 时才会被接受。文本学习率预算、被拒绝编辑缓冲区,以及按 epoch 进行的 slow/meta update,使 skill training 保持稳定,同时在部署时不增加任何推理阶段模型调用。在六个 benchmarks、七个 target models 和三种 execution harnesses(direct chat、Codex、Claude Code)上,SkillOpt 在全部 52 个被评估的 model–benchmark–harness 单元中都是最佳或并列最佳,并击败了 human、one-shot LLM、Trace2Skill、TextGrad、GEPA 和 EvoSkill skills 中每个单元的所有竞争方法。在 GPT–5.5 上,它将 no-skill 平均准确率在 direct chat 中提升 +23.5 points,在 Codex agentic loop 中提升 +24.8,在 Claude Code 中提升 +19.1。迁移实验进一步表明,优化后的 skill artifacts 在跨模型规模、Codex 与 Claude Code 执行环境之间,以及迁移到相近数学 benchmark 时,无需进一步优化仍然保留价值
1. 背景
1.1 Skill 及其优化
- Skill 本质上是教 LLM-agent 按固定流程做事的操作说明书,它把某一类任务所需的程序性知识、领域约束、参考模板、工具使用方法与输出规范封装起来,形成一个可以重复调用的工作单元,一旦写好,就能像函数一样反复调用。详见 LLM-based Agent 技术演进 —— 从 Prompt Engineering 到 Harness
- 由于复杂、个性化任务的完整轨迹存在长尾分布特性,LLM-agent 难以直接完成。传统意义上,这种 domain adaptation 往往是在模型权重、prompt 或数据上动手,但 agent 场景里很多长尾任务强依赖于 “外部过程知识”:如何找证据、如何调用工具、如何处理表格或文档、如何格式化答案、哪些失败模式要避免,这类任务知识就非常适合收敛到一个可复用 Skill 中
- 对于这类复杂长尾任务,Skill 提供 “外部过程知识” 的质量直接决定了输出结果的质量,因此其域适应的对象就是 Skill(执行流程),实现 Skill 的自动优化便成为重要的课题
- 从最早的 “Prompt Engineering” 到现在的 “Skill”,自动优化 prompt 并不是新鲜的课题
- 2022 年,APE 说自动生成的指令「超越人类水平」
- 2023 年,OPRO 让 LLM 自己当优化器,优化出来的最强咒语是「Take a deep breath」
- 2024 年,TextGrad 发明了「文本梯度」这个词
- 2025 年,GEPA 的标题直接写「反思式进化超越强化学习」
- skill 这一波直接寒武纪大爆发:Trace2Skill、EvoSkill、EvoSkills、SkillForge、SkillClaw、SKILLFOUNDRY、AutoSkill、SkillRL、SkillX、AutoRefine
- 随着 LLM-agent 能力的提升,相关工作已经越来越多,prompt、skill、memory、context、工具、workflow、agent 架构、harness、reward,一个 agent 身上每个零件都有专门的论文在「自动优化」
- agent 和 harness 层面:meta-agent 写代码发明新 agent;AFlow用 MCTS 去搜 multi-agent workflow;AgentSquare 把 agent 拆成 planning、reasoning、tool use、memory 四个模块,然后搜模块的排列组合
- memory 也要自动进化:Dynamic Cheatsheet 给模型配了张自我更新的小抄;A-Mem用 Zettelkasten 卡片盒笔记法给 agent 管记忆
- 工具也要自动造:LATM 让大模型自己造工具给另一个模型用,CREATOR、CRAFT 跟上,Voyager 在 Minecraft 里攒了一整库技能代码
- 奖励也要自动:Self-Rewarding 让模型自己给自己打分
- 从最早的 “Prompt Engineering” 到现在的 “Skill”,自动优化 prompt 并不是新鲜的课题
1.2 现有方法的问题
- 论文主要对比了几类已有路线:
- Human skill:专家手写规则,质量依赖人工经验,难以针对新 harness / benchmark 快速迭代
- One-shot LLM skill:让 LLM 看任务描述一次性写 skill,缺少真实执行反馈
- Trace2Skill / trajectory lesson distillation:从轨迹里抽规则,但如果没有验证 gate,容易把局部失败的修补写进最终交付 Skill 中导致过拟合
- TextGrad / GEPA 这类文本或 prompt 优化:能用反馈修 prompt,但优化对象通常不是一个持久、可部署、可跨 harness 迁移的 skill 文档
- EvoSkill 这类 skill evolution:能进化 skill 文件夹,但缺少类似深度学习训练里的 step size、validation、rejected update memory 这些稳定性约束。
- 作者的核心批评是:skill 的改写如果没有受控步长和质量过滤,很容易发生语义大跳跃。一次 “看起来合理” 的大改写可能删除原本有效的规则、引入冲突指令,或者过拟合某一批失败样本
2. 本文方法
2.1 问题设定:把 skill 文档当成外部状态
-
本文将 Skill 的文本内容作为优化对象,把优化神经网络的梯度下降优化器那一套平移过来,如下图所示
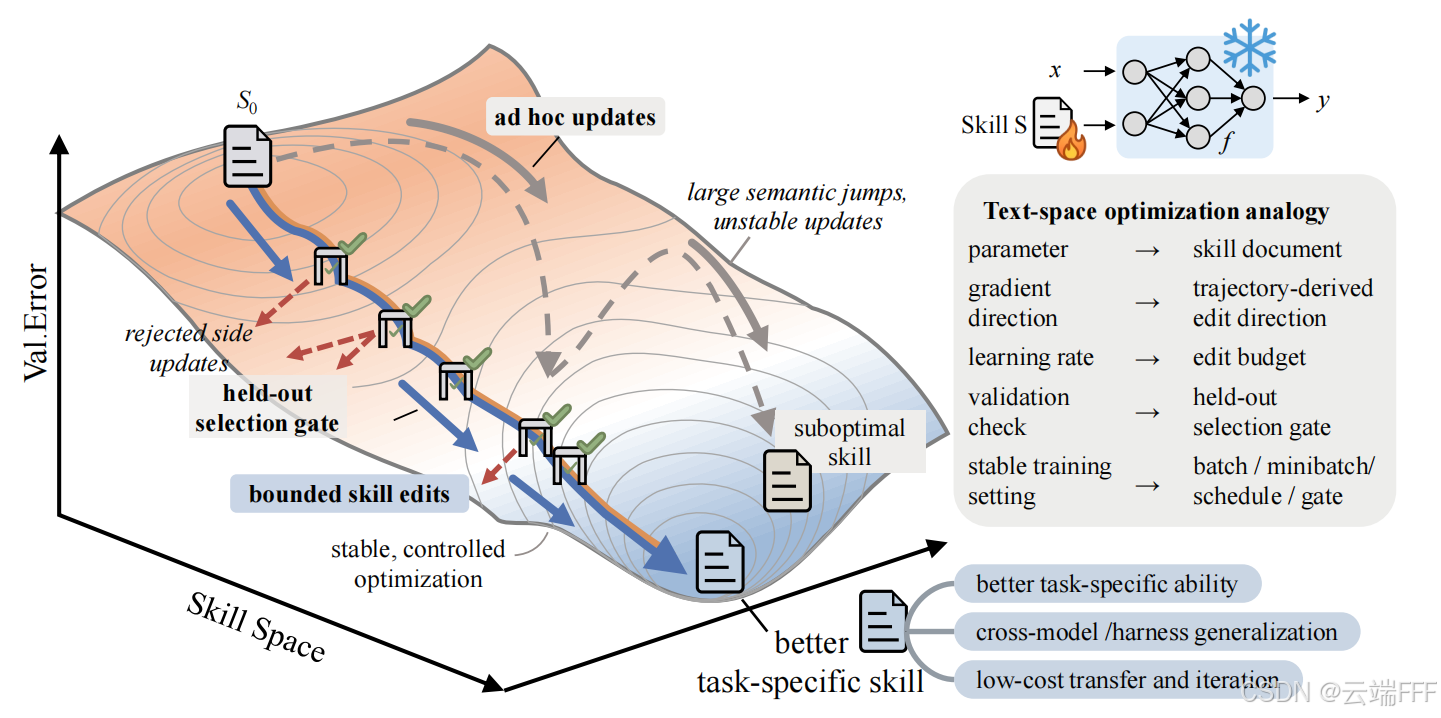
- 参数 → skill 文档
- 梯度方向 → 从轨迹中提取的编辑方向
- 学习率 → 文本编辑预算(可以更新多少内容)
- 验证集检查 → held-out selection gate
- 稳定训练设置 → batch、minibatch、schedule、gate 等机制
-
基于以上思路给出 Skill 优化任务的定义:给定由冻结的目标模型 和执行环境/harness 组成的 agent 系统,要求优化自然语言 skill 文档 以提升 agent 系统在指定任务 上的表现。任务执行过程会产生一条轨迹 和一个标量评分
SkillOpt 的训练过程类似 RL 在线优化过程或演化学习过程,其 “训练数据” 不是静态监督样本,而是一组用于在线 rollout 的任务样本/新问题集合,只是优化对象从模型权重变成了外部 skill 文档:
- 训练集 ,用来产生 rollout evidence
- 验证集 :用来决定候选 skill 是否接受
- 测试集 :只在最终报告中使用
-
SkillOpt 首先使用训练集 生成一组候选技能 ,然后利用验证集 找到性能最优的 skill 示例,并汇报在测试集 上的最终性能
这里最重要的是:训练阶段可以不断试错,但最终选择必须由 selection split 决定。SkillOpt 不是 “LLM 反思后直接相信自己”,而是 “LLM 提案,验证集裁决”
2.2 整体流程:rollout、反思、编辑、验证
-
SkillOpt 每一步大致做六件事:agent rollout、失败/成功 minibatch 反思、patch 合并、按文本学习率裁剪、skill 更新、门控验证。如下图所示,冻结的目标模型使用当前技能执行批量训练;优化器模型对成功与失败案例进行小批量反思,提出有界范围内的增删替换修改方案,在预定编辑预算内对这些方案进行合并排序,并仅通过预留的验证门筛选出候选技能。在多个训练周期中,慢速元模型更新机制可在不改变目标模型的前提下保留更长期限的学习经验
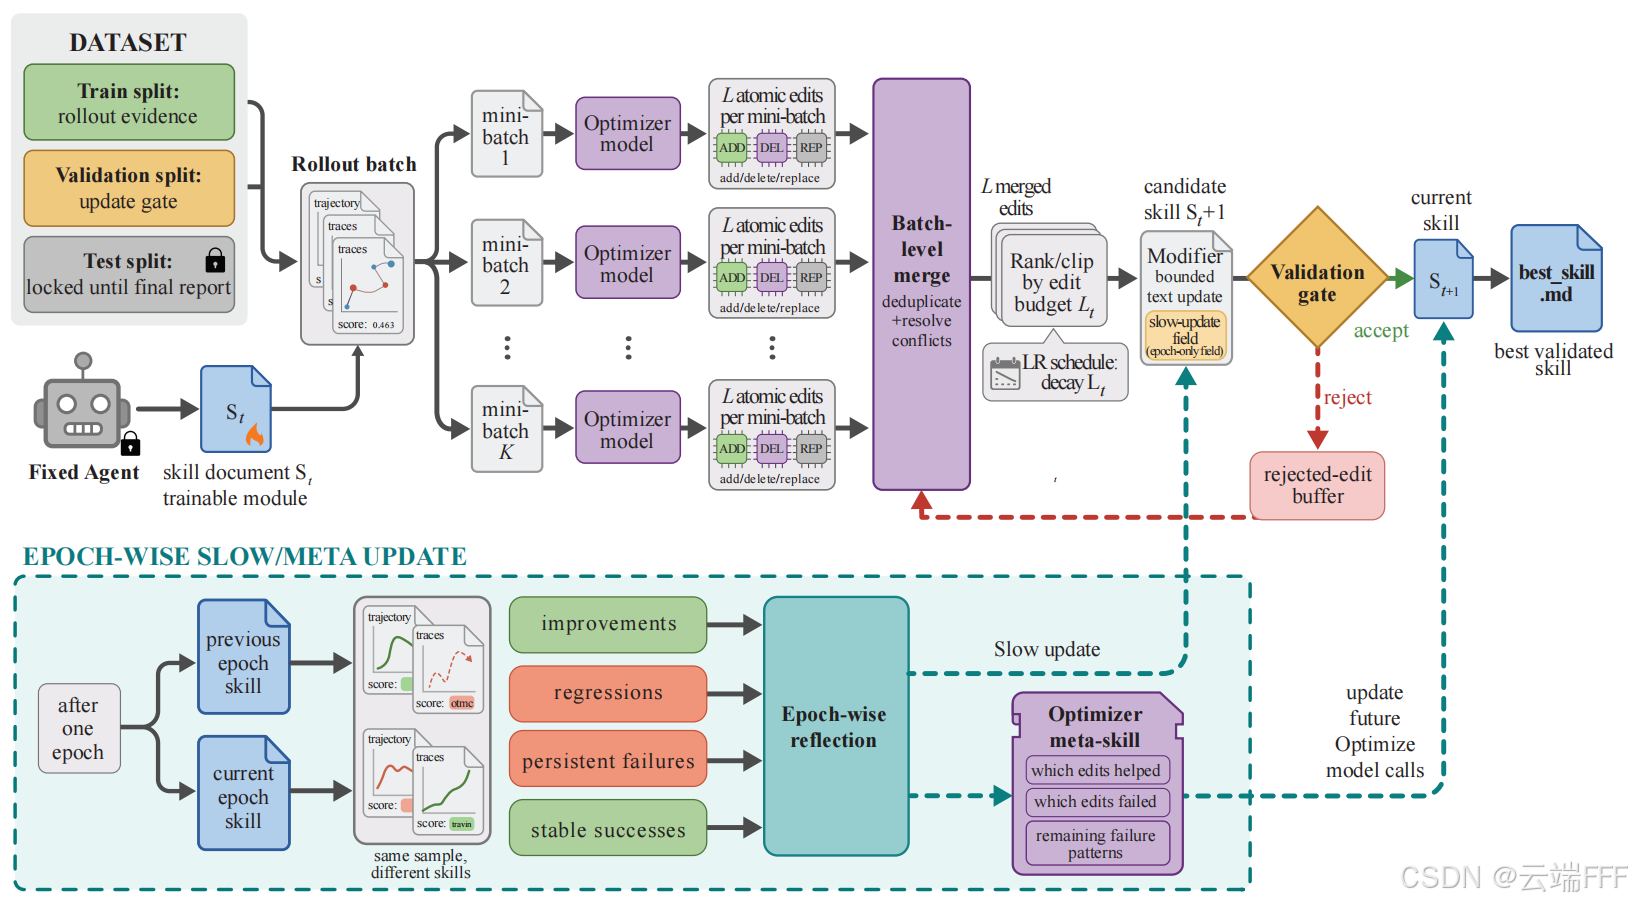
可以把这个流程理解成一种文本版训练循环:
- Forward pass:冻结目标模型 带着当前 skill 在训练 mini batch 上执行任务,产生轨迹和分数
- rollout batch 不是只记录最终答案,而是尽量保留 agent 做了什么,包括 task metadata、messages、tool calls、observations / command outputs、final answer、verifier feedback 和对 spreadsheet、document、embodied task 的环境特定摘要 等
- 这一步对应深度学习里的 forward pass,但产生的不是 logits 和 loss,而是可读的 execution trace。后续 optimizer model 需要从这些 trace 中判断:失败是否来自检索源错误、格式不对、工具调用不足、表格字段绑定错误,还是长期搜索策略不稳定
- Backward pass:针对每个 minibatch,优化器模型 读失败和成功轨迹,把经验转成 add/delete/replace 候选编辑
- 论文特别强调 minibatch reflection 而不是单条 trajectory reflection,因为单条失败很容易诱导出特例规则,minibatch 才更容易看到可泛化模式
- 优化器模型将 rollout batch 中的轨迹按任务达成情况换分为成功与失败 reflection minibatches,每个 reflection minibatch 会让 optimizer model 生成一组候选 skill edits
- 失败 minibatch 提出纠正性规则,例如搜索任务里不要只看第一个检索结果、表格任务里先检查 workbook 结构和公式、ALFWorld 里记录已访问位置避免循环等
- 成功 minibatch 提出应保留的有效行为:哪些已经有效的行为要保留,哪些规则不应该被后续编辑覆盖
- Gradient aggregation:失败编辑和成功编辑分开合并,最终合并时失败修复优先
- Backward pass 过程得到了一组局部 skill edits,真正更新之前需要进行会融合、去重、消冲突:首先分别整合基于失败和成功情况的修改建议,最后整合时失败修复优先级更高,即 failure 和 success 覆盖同一点时保留 failure 版本,除非和 “强支持” 的 success pattern 直接冲突
- 这种设计很像优化器里对 noisy gradient 做聚合,不过这里聚合对象是自然语言 patch
- Learning rate clipping:只保留最多 个编辑,避免一次改太多,得到候选 skill
- SkillOpt 的学习率不是一个浮点数,而是一个整数编辑预算 :每一步最多允许多少条 skill edit 被应用。编辑预算和学习率一样可以动态调度,默认的余弦调度方案从较多的修改步骤开始,逐渐 递减至较少的整合步骤
- 这一步的直觉是:自然语言 skill 的 “参数空间” 很离散,不能指望一次大改写后仍然保留优化历史。让相邻 skill 版本足够接近,skill edit 才有可学习意义。
- Validation gate:只有 在 上严格优于当前 skill,才接受更新
- 在验证集 上重新执行得到的候选 skill ,如果分数高于当前 skill 则更新 current skill,如果还高于历史最好分数则更新
best_skill.md。这个 gate 是严格的,候选 skill 只要没有明确提升,就不会让系统漂移 - 未能提升分数被拒绝的 skill edit 作为负反馈进入当前 epoch 的 rejected-edit buffer,每个负样本记录的信息为:观测到的失败模式 + 尝试的 skill edit 及其导致的得分下降值。后续在同一训练周期内的推理调用均可获取该缓冲区数据,从而使优化模型能够避免重复执行失败的修改操作,并专注于处理尚未解决的故障问题。里我觉得是本文最像真实优化器的地方:负反馈不部署,但会影响后续搜索方向
- 在验证集 上重新执行得到的候选 skill ,如果分数高于当前 skill 则更新 current skill,如果还高于历史最好分数则更新
- Epoch-wise slow/meta update:每个 epoch 末比较前一版 skill 与当前 skill 在相同训练样本上的表现,optimizer model 据此写一个受保护的 slow-update guidance block,用于给目标 skill 文档加入长期指导,其只用于训练过程,不随最终 skill 部署
-
前面 1-5 的 fast update 只看当前 batch 的证据;slow/meta update 则在 epoch 边界比较同一批样本在前一 epoch skill 和当前 epoch skill 下的表现,默认每个 task 采样 20 个训练样本进行评估
-
所有评估问题根据性能差异分成四组,
-
improvements改好了:当前修改带来了有效改进,应保留相关 edit 策略 -
regressions改差了:新 skill 破坏了原有能力,应避免类似修改 -
persistent failures都错:仍然存在长期盲点,需要后续重点修 -
stable successes都对:这些行为模式是稳定有效的,不要被后续编辑破坏 -
优化器 LLM 接收旧 epoch skill、当前 epoch skill、所有采样任务在两个 skill 下的纵向比较,以及上一轮 slow guidance;然后要求它保留有效指导、修改或移除无效指导,并增加针对新 regression 和 persistent failure 的指令,写出一段新的战略性 guidance block,它起到类似动量的作用,用来约束后续 skill 编辑方向,防止局部 patch 反复漂移或破坏已有能力
-
- Forward pass:冻结目标模型 带着当前 skill 在训练 mini batch 上执行任务,产生轨迹和分数
-
注意,以上流程都是文中默认的 patch mode,作者还另外提出来一种 rewrite mode,通过调整优化器超参数进行全局设置。区别如下
Patch mode局部补丁式修改:论文实验里的默认模式,optimizer model 输出结构化的局部 skill edit(append、insert_after、replace、delete 等),其优点是变化幅度小、可追踪、稳定,也更符合论文强调的 bounded text update 概念Rewrite mode重写模式:该模式下 optimizer model 操作的对象不是 skill 本体,而是 rewrite suggestions,然后在用这些 suggestions 条件化地生成完整的新版 skill。其自由度更大,适合当前 skill 结构很乱、需要整体重组的时候;但风险也更高,因为可能不小心删掉已有有效规则、引入不兼容指令,或者对局部失败过拟合。论文也明确批评 unbounded rewrites 可能擦除有用规则、引入冲突或过拟合局部失败
3. 实验
3.1 实验设定
- Benchmark 覆盖六类任务:
- SearchQA:检索式问答。
- SpreadsheetBench:需要 spreadsheet 代码和工具操作,默认 multi-round codegen,最多 30 turns,并使用 openpyxl/pandas runtime。
- OfficeQA:本地文档工具、多轮工具调用,最多 24 tool calls。
- DocVQA:多模态文档理解。
- LiveMathematicianBench / LiveMath:数学选择题推理。
- ALFWorld:具身环境交互,最多 50 steps。
- 目标模型覆盖 7 个模型:从 GPT-5.5 到 GPT-5.4、GPT-5.4-mini、GPT-5.4-nano、GPT-5.2,以及 Qwen3.5-4B 和 Qwen3.6-35B-A3B。
- 三种执行模式:
- direct chat:单次 chat completion,skill 放在 system prompt 前面。
- Codex harness:用 Codex CLI 在 workspace-write sandbox 中执行任务,SkillOpt 把当前 skill 写成每个任务旁边的
SKILL.md,再读取codex_trace_summary.txt作为反思上下文。 - Claude Code harness:用 Claude Code CLI 镜像同样的 workspace contract。
- Baselines 包括:
- no skill;
- human skill;
- one-shot LLM skill;
- Trace2Skill;
- TextGrad;
- GEPA;
- EvoSkill。
- 评价协议上,使用确定性的 train/selection/test 数据划分。验证集只用来接受或拒绝 candidate skill,所有汇报分数都在不相交的测试集上计算
3.2 实验结果
3.2.1 主结果:52/52 个单元最佳或并列最佳
-
实验设定:在 direct chat、Codex harness 和 Claude Code harness 下,对多个模型、多个 benchmark、多个 skill source 进行 held-out test 比较,分数是百分比;蓝色行是 SkillOpt,小绿/红数字是相对 no-skill 的增减
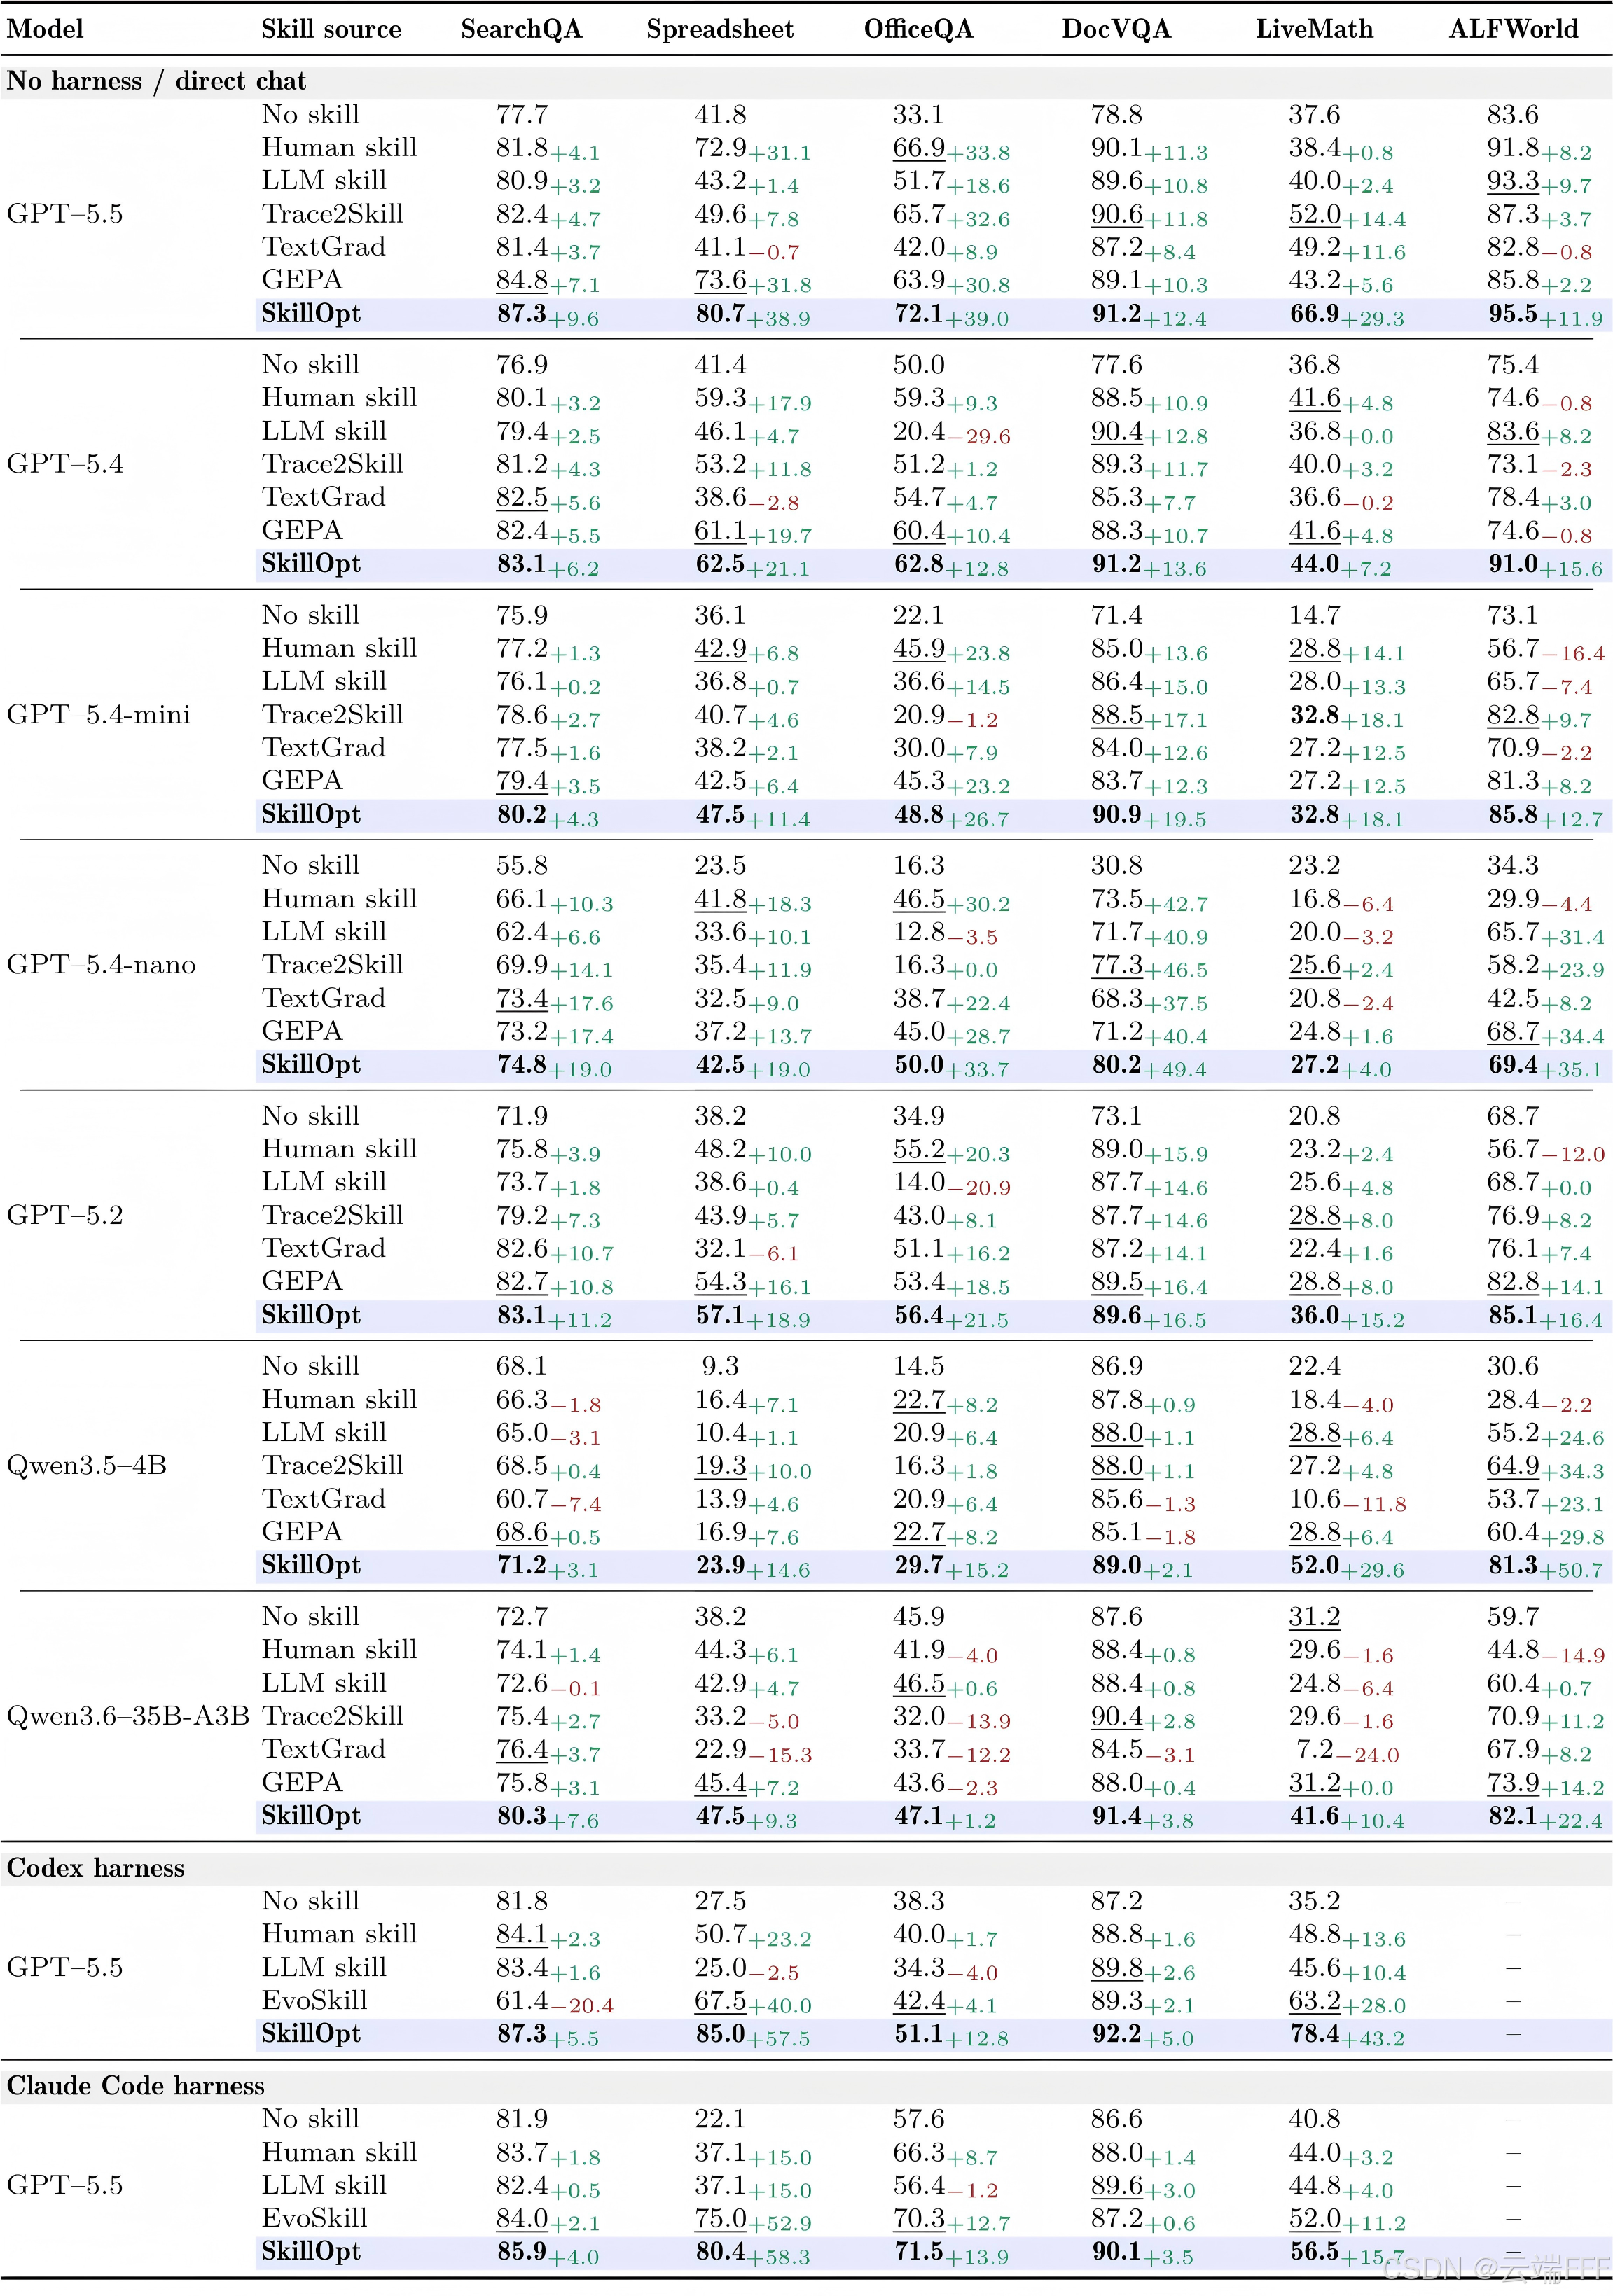
- SkillOpt 在所有 52 个被评估的 单元上达到 best-or-tied-best
- GPT-5.5 direct chat 六个 benchmark 平均从 58.8 提升到 82.3,即 +23.5 points
- 最大增益出现在更依赖程序化流程和格式纪律的任务上:SpreadsheetBench 从 41.8 到 80.7,OfficeQA 从 33.1 到 72.1,LiveMath 从 37.6 到 66.9
- 小模型收益更明显,例如 GPT-5.4-nano 在 DocVQA 近乎翻倍,在 ALFWorld 近乎三倍,这说明 skill artifact 可能在补小模型权重里缺失的过程知识
-
主实验把 “强模型 + 弱模型 + 工具 harness + 非工具 direct chat” 都覆盖了,如果 SkillOpt 只是 prompt trick,通常很难同时在 Codex/Claude Code 这种执行环境迁移里也稳定占优,说服力强
3.2.2 超参和组件消融:稳定性主要来自 gate、bounded edit 和 slow/meta
-
实验设定:使用 GPT-5.5 骨干驱动 agent 和 optimizer,改训练集大小、reflection minibatch size、rollout batch size、learning rate、scheduler 和 slow-update samples 等超参数
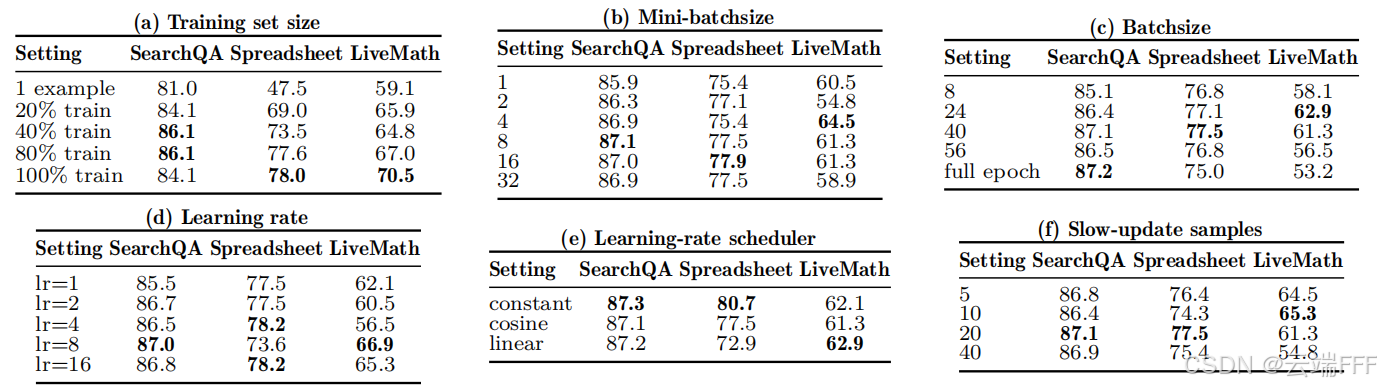
- 训练数据越多,程序型任务收益越明显:SpreadsheetBench 从 1 example 的 47.5 提升到 100% train 的 78.0,LiveMath 从 59.1 到 70.5。 2. reflection minibatch size 和 rollout batch size 鲁棒性强:SearchQA 和 SpreadsheetBench 在多个设置下波动较小。
-
使用 GPT-5.5 骨干驱动 agent 和 optimizer,移除学习率形式、rejected buffer、meta skill / slow update 等组件进行消融
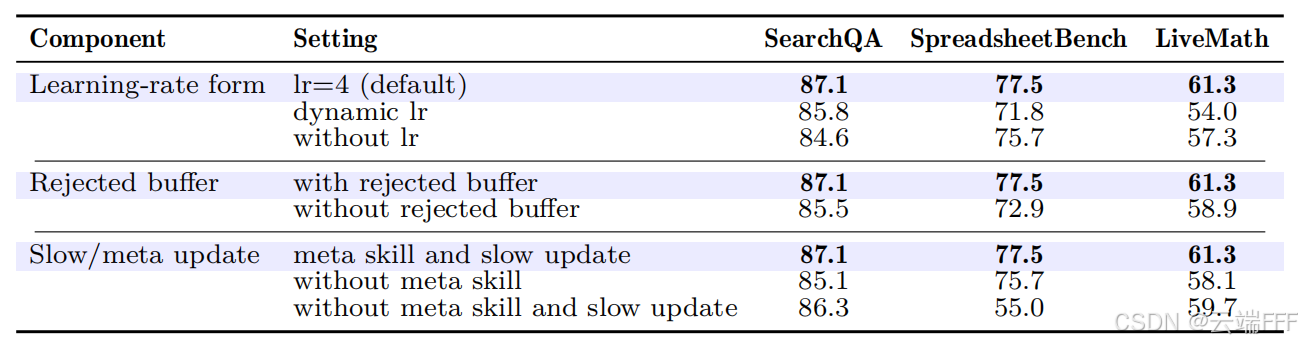
- 学习率控制/编辑约束提升了性能:没有 learning-rate control 时,SearchQA / SpreadsheetBench / LiveMath 性能低于默认
- rejected buffer 有稳定增益:去掉后 SpreadsheetBench 从 77.5 掉到 72.9。
- 优化器的 slow/meta update 是核心:去掉后 SpreadsheetBench 从 77.5 掉到 55.0,是整张消融里最明显的退化
-
这组实验说明 SkillOpt 不是靠某个神奇 batch size 调出来的,而是依赖一套组合约束:步长要小、候选要验证、失败编辑要记住、跨 epoch 经验要单独沉淀
3.2.3 训练趋势:selection gate 能较好追踪 unseen test,但不一定
-
下图 SpreadsheetBench、SearchQA、LiveMath 在 epoch checkpoint 上的 train rollout、selection best 和 unseen test 曲线
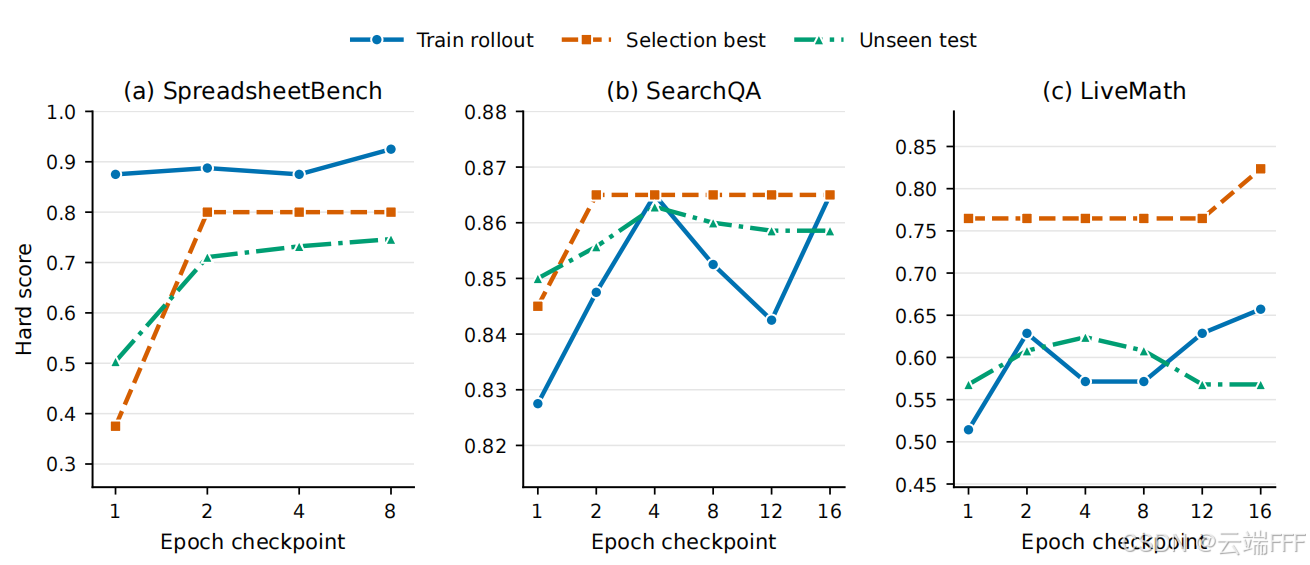
- SpreadsheetBench 的 selection best 很快从低分区间跳到 0.8 左右,unseen test 也同步上升,说明 gate 没有只挑 selection overfit 的 skill。
- SearchQA 的曲线空间较小,因为 no-skill 已经接近高分区间,优化更多是在小幅稳定提升。
- LiveMath 中 selection best 后期继续升高,但 unseen test 没有同幅上升,说明即使有 gate,数学选择题的泛化仍然存在更大波动
-
这张图也提醒一个限制:SkillOpt 的 gate 只能约束 selection split 上的可观测性能,不能完全消除 domain shift 或 benchmark 小样本噪声
3.2.4 迁移实验:skill 更像可复用 artifact,而不是一次性 prompt
-
作者考察了使用一种骨干模型/agent系统优化的 skill 迁移到其他模型/agent系统后的表现
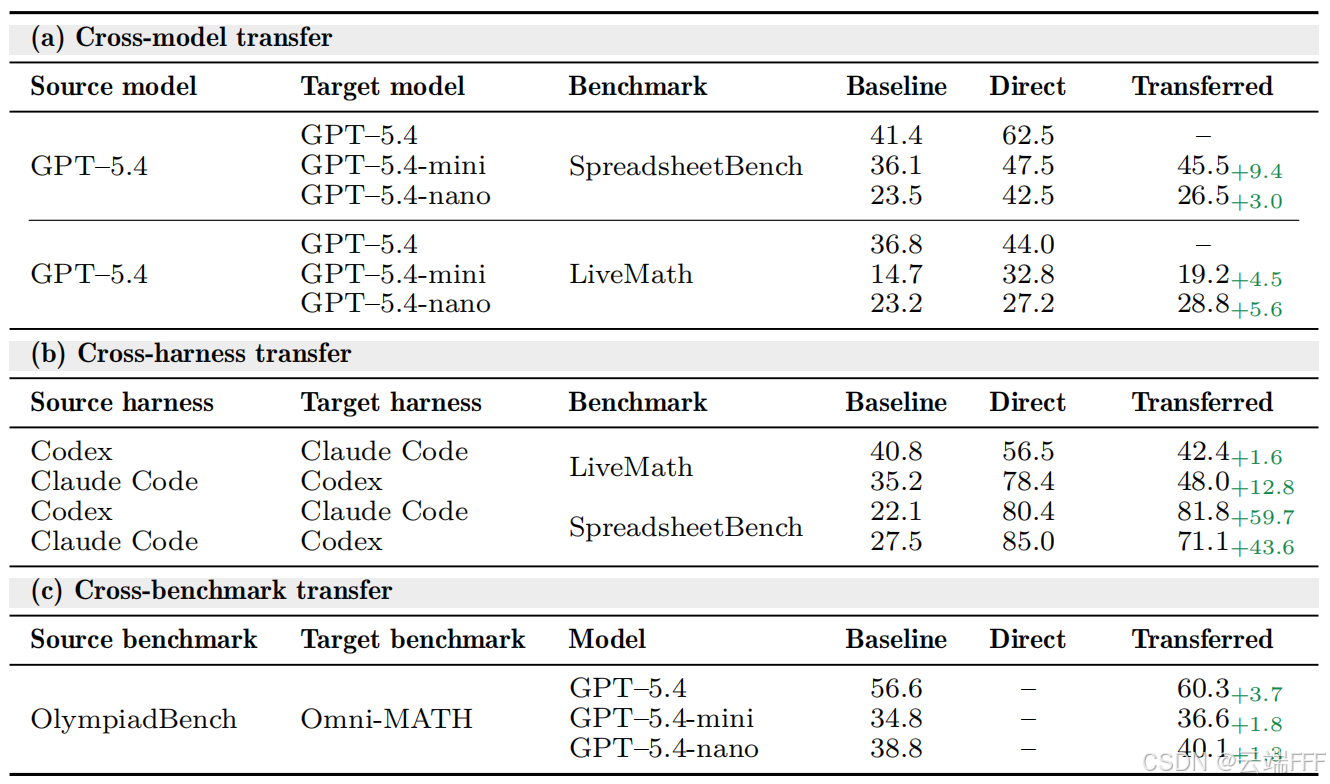
- GPT-5.4 上训练的 SpreadsheetBench skill 转到 GPT-5.4-mini 有 +9.4,转到 GPT-5.4-nano 有 +3.0
- LiveMath skill 跨模型也都是正迁移,其中 GPT-5.4-nano 上 transferred 28.8 甚至超过 direct in-domain 27.2
- 跨 harness 最强的是 SpreadsheetBench:Codex 到 Claude Code 从 22.1 提到 81.8,即 +59.7;Claude Code 到 Codex 从 27.5 提到 71.1,即 +43.6
- OlympiadBench 到 Omni-MATH 的跨 benchmark 迁移较小但全部为正,分别是 +3.7、+1.8、+1.3
-
我理解这里的重点是:如果 learned skill 只是 Codex 的命令模板,它不应该在 Claude Code 里也大幅有效;如果只是 benchmark-specific answer formatting,它也不该跨模型和近邻数学 benchmark 正迁移。迁移结果支持作者的说法:最终 skill 学到的是较抽象的程序知识
4. 代码分析
4.1 伪代码
- 下面是我根据官方仓库
skillopt/engine/trainer.py、skillopt/gradient/aggregate.py、skillopt/optimizer/clip.py、skillopt/evaluation/gate.py和skillopt/optimizer/slow_update.py重构的简化伪代码,保留工程实现中的主要状态、缓存和 gate 逻辑1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95def train_skillopt(cfg, adapter):
# adapter 把不同 benchmark / harness 接到统一接口:
# rollout 负责执行目标模型,reflect 负责把轨迹转成候选编辑。
adapter.setup(cfg)
dataloader = adapter.get_dataloader()
current_skill = load_initial_skill(cfg.skill_init)
best_skill = current_skill
# selection 分数缓存按 skill hash 存,避免同一个候选 skill 重复评估。
selection_cache = {}
current_score = evaluate_on_selection(current_skill, adapter, selection_cache)
best_score = current_score
# 文本学习率调度器:这里输出的不是浮点学习率,而是每步最多编辑数 L_t。
scheduler = build_scheduler(
mode=cfg.lr_scheduler,
max_lr=cfg.edit_budget,
min_lr=cfg.min_edit_budget,
total_steps=cfg.total_steps,
)
for epoch in range(cfg.num_epochs):
step_buffer = [] # 记录本 epoch 的失败模式和被拒绝编辑,作为负反馈
meta_skill = load_optimizer_meta_skill(epoch - 1)
for batch in dataloader.train_batches(epoch):
# 1. 冻结目标模型带着当前 skill 执行任务,收集 scored trajectories。
rollout_results = adapter.rollout(batch, current_skill)
# 2. optimizer model 分析失败和成功轨迹,提出 add/delete/replace patch。
failure_patches, success_patches = adapter.reflect(
rollout_results,
current_skill,
step_buffer_context=step_buffer,
meta_skill_context=meta_skill,
)
# 3. 先合并失败编辑,再合并成功编辑,最终 failure-prioritized merge。
merged_patch = merge_patches(
current_skill,
failure_patches,
success_patches,
meta_skill_context=meta_skill,
)
# 4. 按 L_t 对编辑池排序和裁剪,避免一次文本更新跨度过大。
edit_budget = scheduler.step()
ranked_patch = rank_and_select(
current_skill,
merged_patch,
max_edits=edit_budget,
meta_skill_context=meta_skill,
)
# 5. 把 patch 应用到 skill;实现会记录每条 edit 是否成功应用。
candidate_skill, apply_report = apply_patch_with_report(
current_skill,
ranked_patch,
)
# 6. held-out gate:只有 selection 分数严格提升才接受。
cand_score = evaluate_on_selection(
candidate_skill,
adapter,
selection_cache,
)
if cand_score > current_score:
current_skill = candidate_skill
current_score = cand_score
if cand_score > best_score:
best_skill = candidate_skill
best_score = cand_score
else:
# 拒绝编辑不会部署,但会进入后续 optimizer context,减少重复踩坑。
step_buffer.append({
"failure_patterns": extract_failure_patterns(rollout_results),
"rejected_edits": summarize(ranked_patch),
"score_before": current_score,
"score_after": cand_score,
})
# 7. epoch 边界比较同一批样本的前后 skill 表现,形成长期 slow guidance。
if cfg.use_slow_update and epoch >= 1:
slow_guidance = run_slow_update(
prev_epoch_skill,
current_skill,
same_sample_rollouts=True,
)
current_skill = replace_protected_slow_update_field(
current_skill,
slow_guidance,
)
return best_skill, best_score
4.2 工程技巧
-
用 adapter 抽象 benchmark / harness,训练循环不关心任务细节。 这让 SearchQA、SpreadsheetBench、OfficeQA、DocVQA、LiveMath、ALFWorld 可以共用同一个
ReflACTTrainer,只需要各自实现rollout和reflect。1
2
3
4
5
6
7
8
9
10
11
12
13# skillopt/envs/base.py
class EnvAdapter(ABC):
@abstractmethod
def rollout(self, env_manager, skill_content, out_dir, **kw):
# 中文注释:执行目标模型并返回统一格式结果,
# 例如 hard/soft 分数、预测答案、失败原因、轨迹摘要。
...
@abstractmethod
def reflect(self, results, skill_content, out_dir, **kw):
# 中文注释:把环境特定轨迹转成通用 patch,
# 训练主循环只需要看到 add/delete/replace 编辑。
... -
配置里把 optimizer model 和 target model 分开。 论文强调 optimizer 只在训练时调用,部署时只用静态 skill;代码也把
optimizer_backend和target_backend分成两个角色。1
2
3
4
5
6
7
8
9
10
11
12
13
14# configs/_base_/default.yaml
model:
optimizer: gpt-5.5
target: gpt-5.5
optimizer_backend: openai_chat
target_backend: openai_chat
codex_trace_to_optimizer: true # 中文注释:Codex 轨迹会进入 optimizer 反思上下文
optimizer:
learning_rate: 4 # 中文注释:文本学习率,即每步最多应用 4 条编辑
min_learning_rate: 2
lr_scheduler: cosine
use_slow_update: true
use_meta_skill: true -
训练主循环显式分成 rollout、reflect、aggregate、select、update、evaluate 六个阶段。 这让每一步都有独立日志和中间文件,方便复现和排查哪个环节引入了坏编辑。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15# skillopt/engine/trainer.py
rollout_results = adapter.rollout(
train_env, current_skill, rollout_dir,
use_eval_feedback=True,
)
raw_patches = adapter.reflect(
rollout_results, current_skill, batch_dir,
step_buffer_context=step_buffer_context, # 中文注释:把本 epoch 拒绝编辑作为负反馈
meta_skill_context=active_meta_skill, # 中文注释:给 optimizer 的长期写作指导
)
merged_patch = merge_patches(current_skill, all_failure_patches, all_success_patches)
ranked_patch = rank_and_select(current_skill, merged_patch, max_edits=edit_budget)
candidate_skill, apply_report = apply_patch_with_report(current_skill, ranked_patch) -
编辑选择模块有 LLM ranking,也有 deterministic fallback。 如果 optimizer ranking 调用失败,代码不会让训练崩掉,而是退回到前 个编辑,这对长实验很重要。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18# skillopt/optimizer/clip.py
if len(edits) <= max_edits:
return patch # 中文注释:编辑数没有超过文本学习率,直接保留。
response, _ = chat_optimizer(
system=load_prompt(prompt_name),
user=user,
max_completion_tokens=2048,
retries=3,
stage="ranking",
)
...
# 中文注释:如果 LLM ranking 失败,就简单截断,保证训练循环可继续。
return {
"reasoning": patch.get("reasoning", "")
+ f" [fallback truncated {len(edits)}->{max_edits} edits]",
"edits": edits[:max_edits],
} -
validation gate 是纯决策函数,便于测试和替换指标。
evaluate_gate不做文件写入和状态副作用,只根据 hard/soft/mixed score 返回 accept/reject。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16# skillopt/evaluation/gate.py
def evaluate_gate(candidate_skill, cand_hard, current_skill, current_score,
best_skill, best_score, best_step, global_step,
cand_soft=0.0, metric="hard", mixed_weight=0.5):
cand_score = select_gate_score(cand_hard, cand_soft, metric, mixed_weight)
if cand_score > current_score:
# 中文注释:必须严格超过当前分数;平分不会接受,避免 skill 静默漂移。
if cand_score > best_score:
return GateResult("accept_new_best", candidate_skill, cand_score,
candidate_skill, cand_score, global_step)
return GateResult("accept", candidate_skill, cand_score,
best_skill, best_score, best_step)
return GateResult("reject", current_skill, current_score,
best_skill, best_score, best_step) -
patch application 会生成逐条编辑报告。 这点很实用:自然语言编辑可能找不到 target、误碰 protected section 或格式不合法,
edit_apply_report.json可以解释某次 skill 变化到底发生了什么。1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16# skillopt/optimizer/skill.py
def apply_patch_with_report(skill, patch):
edits = patch.edits if hasattr(patch, "edits") else patch.get("edits", [])
reports = []
for idx, edit in enumerate(edits, 1):
try:
skill, report = _apply_edit_with_report(skill, edit)
report["index"] = idx # 中文注释:保留原始编辑序号,方便回溯。
except Exception as exc:
report = {
"index": idx,
"status": "error", # 中文注释:失败不吞掉,而是写入报告。
"error": str(exc),
}
reports.append(report)
return skill, reports -
slow update 输入的是同一批样本的前后 epoch 对比。 这比只看当前失败更强,因为它能看到 regressions、persistent failures 和 stable successes。
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18# skillopt/optimizer/slow_update.py
def run_slow_update(skill_content, results_prev, results_curr, items, ...):
pairs = build_comparison_pairs(
results_prev, results_curr, items,
prev_rollout_dir=prev_rollout_dir,
curr_rollout_dir=curr_rollout_dir,
)
comparison_text = format_comparison_text(pairs)
user = (
f"## Previous Epoch's Skill\n{prev_skill}\n\n"
f"## Current Epoch's Skill\n{skill_content}\n\n"
# 中文注释:optimizer 看到的是纵向变化,而不是单次 batch 失败。
f"## Longitudinal Comparison (same 20 tasks, two skill versions)\n"
f"{comparison_text}"
)
response, _ = chat_optimizer(system=load_prompt("slow_update"), user=user, ...)
return extract_json(response)
5. 总结
- SkillOpt 的主要贡献不是“又写了一个自动 prompt 优化器”,而是把 skill optimization 组织成了更接近训练系统的形式:有 train/selection/test,有 batch,有 learning-rate-like edit budget,有 gate,有 rejected update memory,有跨 epoch 的慢变量。
- 我认为这篇文章最有价值的点在于它把 agent skill 从 “经验型文档” 推向 “可训练 artifact”。最终部署物仍然只是 300-2000 tokens 的
best_skill.md,这对实际工程很重要:成本在离线训练时支付,线上不增加 optimizer 调用
5.1 创新思想来源
- 从论文叙述看,SkillOpt 的核心思想大概率来自三条线的结合:
- 深度学习优化器类比:参数、梯度、学习率、验证集、动量分别映射到 skill 文档、轨迹编辑方向、edit budget、selection gate、slow/meta update。
- trajectory reflection / prompt evolution:利用执行轨迹发现失败模式,但把反思结果约束为结构化 patch。
- agent skill 作为外部程序记忆:skill 不是一次性 prompt,而是可以跨模型、跨 harness 复用的程序化知识载体。
- 巧妙的一点是,作者没有试图把自然语言 skill 变成连续向量再优化,而是承认它是文本 artifact,然后构造了文本空间控制优化器,这种稳定性设计是 SkillOpt 相对传统文本优化的重要进步。这里最重要的是 Epoch-wise Slow/Meta Update 机制,它让优化不只依赖当前 batch 的局部反馈,而能在 epoch 层面对长期有效经验进行沉淀,消融实验强调了其重要作用,说明复杂工具链任务非常依赖跨周期的全局经验沉淀
5.2 未来展望
- 多 skill / skill library 场景:本文主要训练一个 compact domain skill。真实 agent 可能有多个 skill,需要研究 skill routing、skill composition、版本管理和冲突消解
- 从文本 Skill 到多模态 / 异构执行知识:本文只考虑了文本 skill,但 skill 不一定只是文本,还可能包括 API 模板、配置脚本、流程图、ontology、决策规则等。未来 Harness 需要把这些都纳入 “可训练外状态空间”
- 从 Offline 优化到 Online 持续进化:SkillOpt 当前更像离线优化,未来可以结合生产环境的非活跃窗口、灰度发布、持续评估,让 skill 在真实业务中持续更新,但要受控、安全、可回滚
- 成本可控性:SearchQA 和 DocVQA 的 token per point 很高,说明长轨迹、多模态或检索任务的优化成本可能不便宜。未来需要更好的 trajectory compression 和 active sampling
- 安全与审计:skill 是自然语言策略,容易携带隐式偏见、工具权限策略或不安全操作习惯。SkillOpt 的 edit report 和 compact artifact 是审计基础,但还需要专门的安全 gate
5.3 反面的声音
- 知乎答主 SimonAKing 对本文进行了批判,指出了 SkillOpt 类方法的四个真实风险:
- prompt sensitivity / spurious prompt search:自动编辑可能学到脆弱措辞
- selection overfitting:反复用验证集 gate,本质上也是在搜索验证集
- evaluator 稀疏与噪声:agent 任务没有程序搜索那种强 evaluator
- 收益随模型能力增强可能下降:尤其是格式、CoT、简单流程类 skill。
- 但它也有一些过度批判:
- 把 SkillOpt 简化成“搜神奇措辞”,忽略了论文中 skill 的 procedure / tool policy / failure mode 属性
- 忽略了论文确实做了 cross-model、cross-harness、cross-benchmark transfer,不能直接说“一换模型就归零”
- 把 multi-agent debate 的问题混入 SkillOpt 批判,相关性不强
- 将所有 evaluator 都说成“几十题 0/1 + LLM 裁判”,与论文中部分 benchmark 的 native hard score / exact-match / runtime scorer 不完全一致
- 对 “说明书提升模型表现” 持贬义,但在 agent 工程中,自动生成和验证说明书本身就是有应用价值的
5.4 Q&A
- SkillOpt 和 prompt optimization 的区别是什么? 两者都在文本空间优化,但 SkillOpt 的优化对象是可部署、可复用的 skill 文档,并且明确使用 rollout batch、bounded edit budget、held-out gate、rejected buffer 和 slow/meta update。prompt optimization 往往更像改写入口 prompt,不一定保留一个稳定的 procedural artifact
- 为什么一定要有 held-out gate? 因为 LLM 反思出来的编辑只是“看起来合理”,不等于对目标模型真的有效。gate 把自我修订变成 propose-and-test:候选 skill 必须在 selection split 上严格提升,否则不进入 current skill
- 为什么 rejected edits 还要保存? 被拒绝的编辑提供负反馈。它告诉 optimizer:这类诊断或这类改写虽然听起来合理,但实际降低了分数。后续 reflection 可以避开同类失败,而部署 artifact 不会被污染
- slow/meta update 和普通 patch 有什么区别? 普通 patch 处理当前 batch 的局部失败;slow/meta update 在 epoch 边界比较同一批样本的前后 skill 行为,关注 regressions、persistent failures 和 stable successes。它更像长期方向或动量,避免每个 step 都只追逐当前 batch
- 这篇论文最可能失败在哪里? 一是 selection split 不足以代表真实测试分布时,gate 会失效;二是复杂 harness 的轨迹很长,optimizer 看到的信息可能被压缩损失;三是如果任务需要新的工具能力或模型知识,而不是 procedural discipline,那么只改 skill 文档可能不够