Transformers库(2)—— Pipeline Pipeline 是 Transformers 库的一个高层次封装类,它可以将数据预处理、模型调用、结果后处理三部分组装成流水线,为用户忽略复杂的中间过程,仅保留输入输出接口 2025-10-01 常用库 > Transformers库 #Transformers库
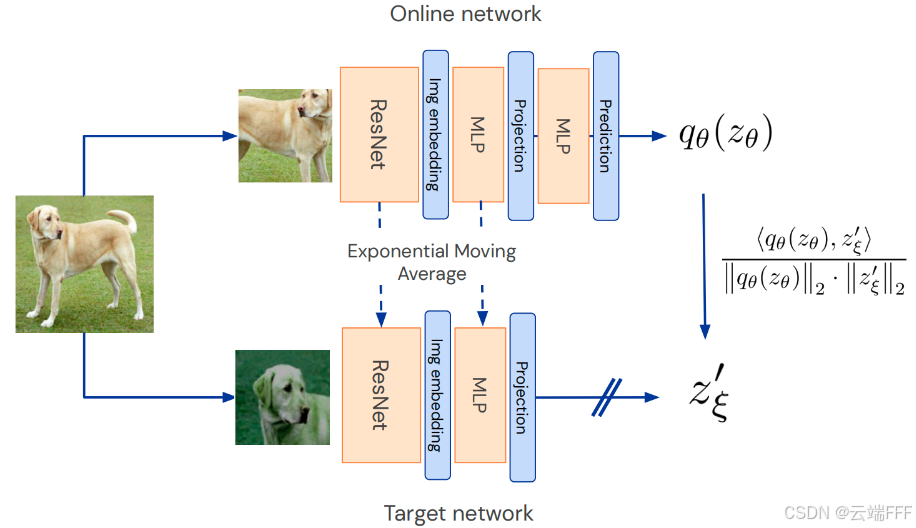
论文理解【CV-对比学习】——【BYOL】Bootstrap Your Own Latent-A New Approach to Self-Supervised Learning BYOL通过两个神经网络的互相学习,提出了第一种无需负样本的新型自监督图像表示学习方法,且在多个基准测试中超越了当时的 SOTA 2025-09-19 机器学习 > 论文理解 > CV-对比学习 #自监督预训练 #对比学习 #CV
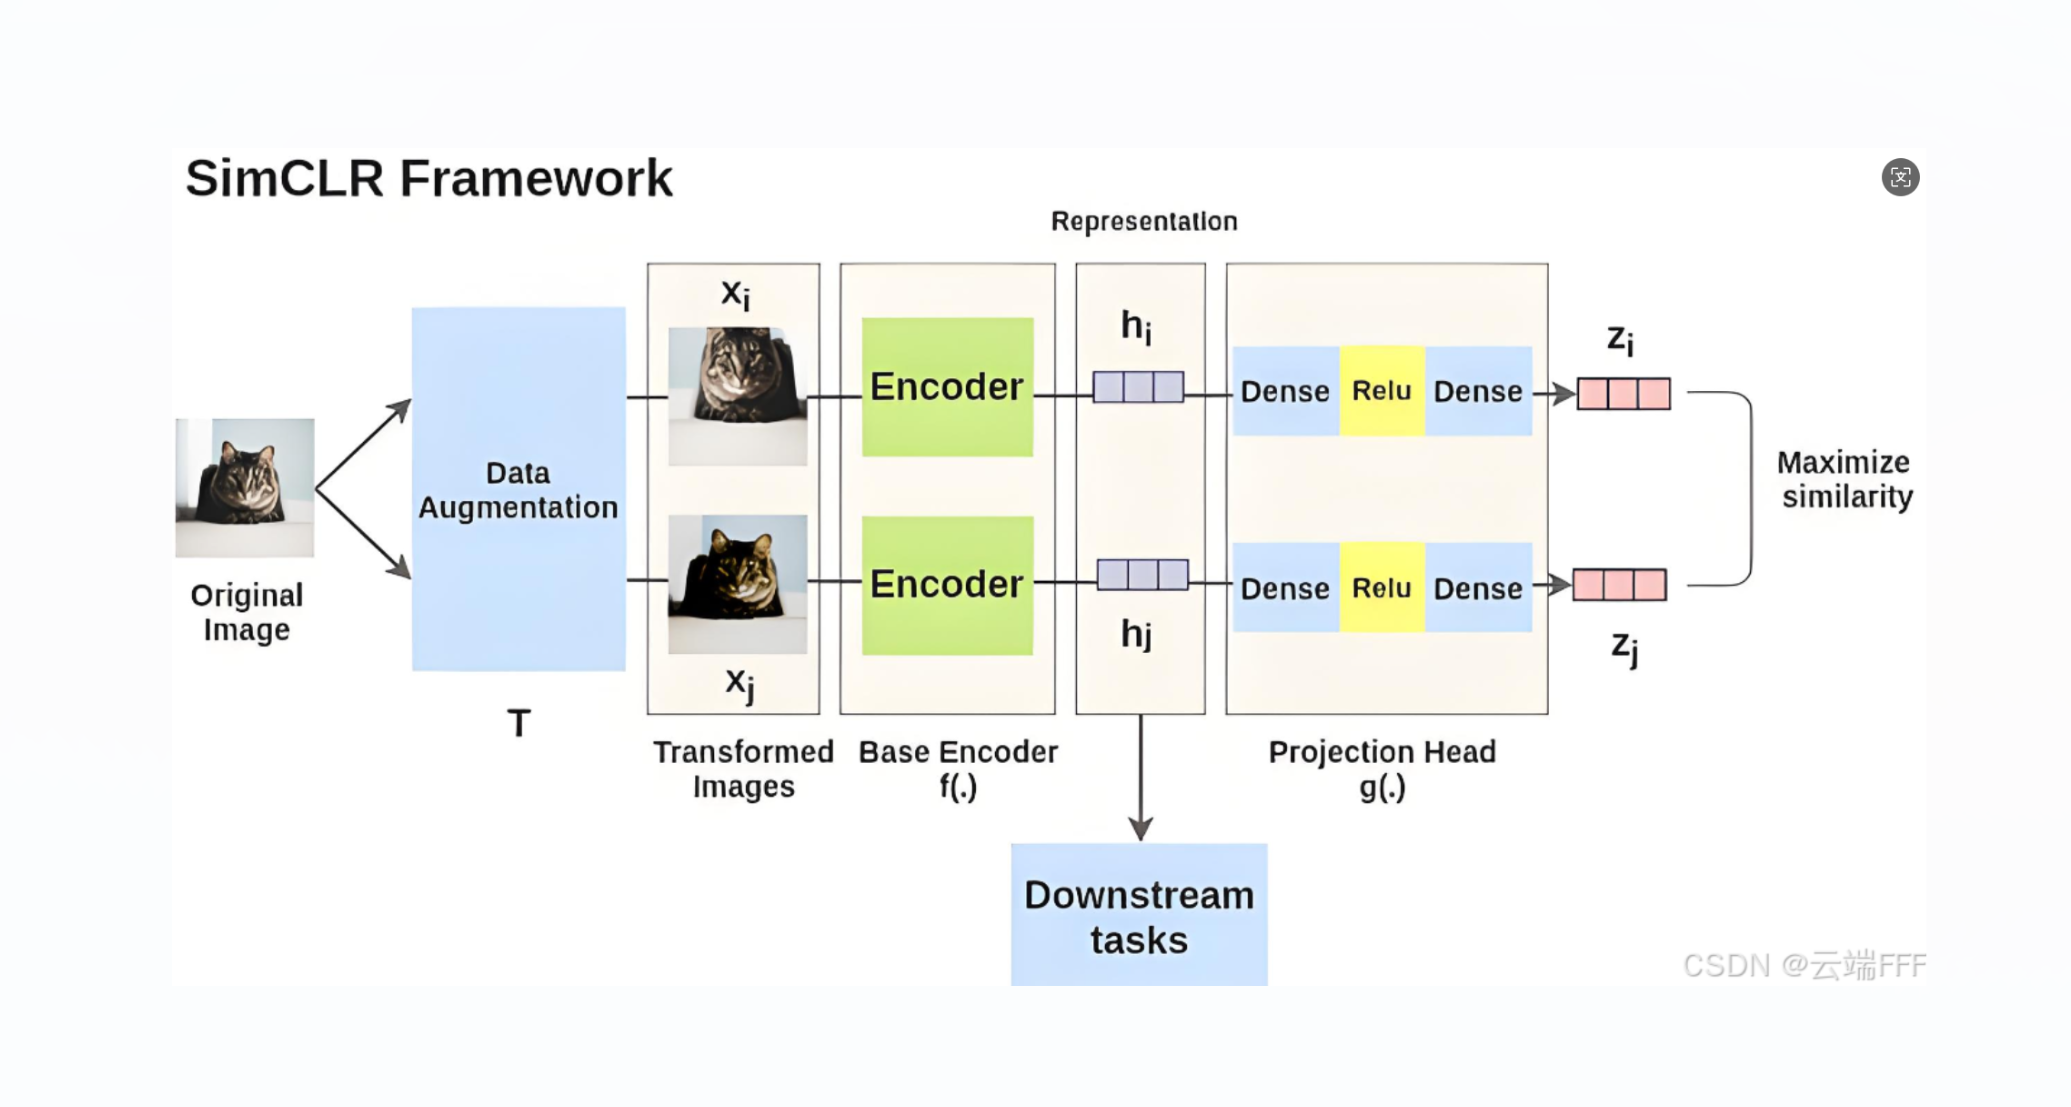
论文理解【CV-对比学习】——【SimCLR】A Simple Framework for Contrastive Learning of Visual Representations SimCLR 是一种简洁的自监督对比学习方法,通过强数据增强、非线性投影头与大批量训练,在无标签条件下学习判别性表示,在线性评估与下游任务中表现优异,大幅减少对人工标注的依赖。 2025-09-15 机器学习 > 论文理解 > CV-对比学习 #自监督预训练 #对比学习 #CV
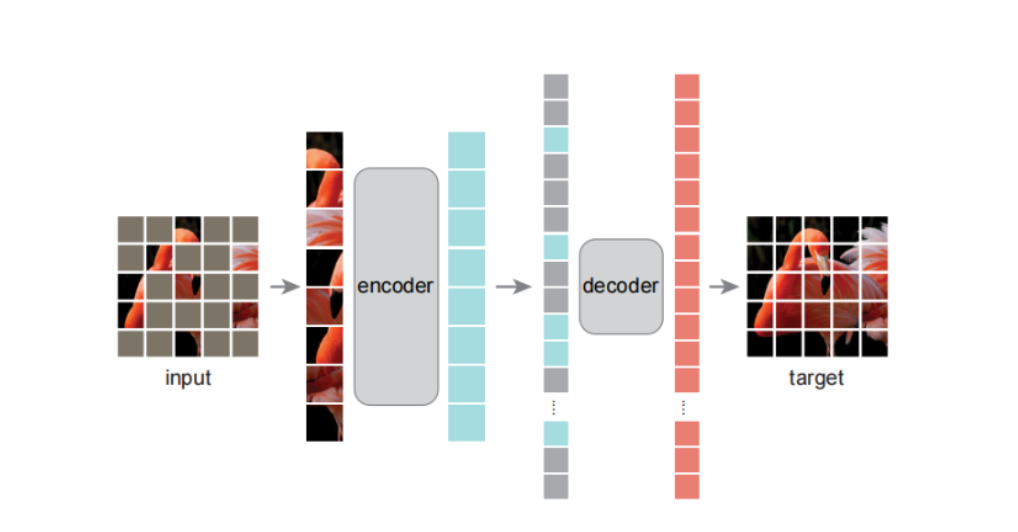
论文理解【Vision Transformer】—— 【MAE】Masked Autoencoders Are Scalable Vision Learners MAE 是一种 Transformer-Based CV backbone,其核心在于使用了类似 Bert 模型的训练机制,通过高比例随机 mask 图像 patch,使用非对称 Encoder-Decoder 架构进行自监督训练重建图像,实现了高效的视觉特征学习。 2025-09-10 机器学习 > 论文理解 > Vision Transformer #自监督预训练 #CV #Transformer-Based #Vision Transformer
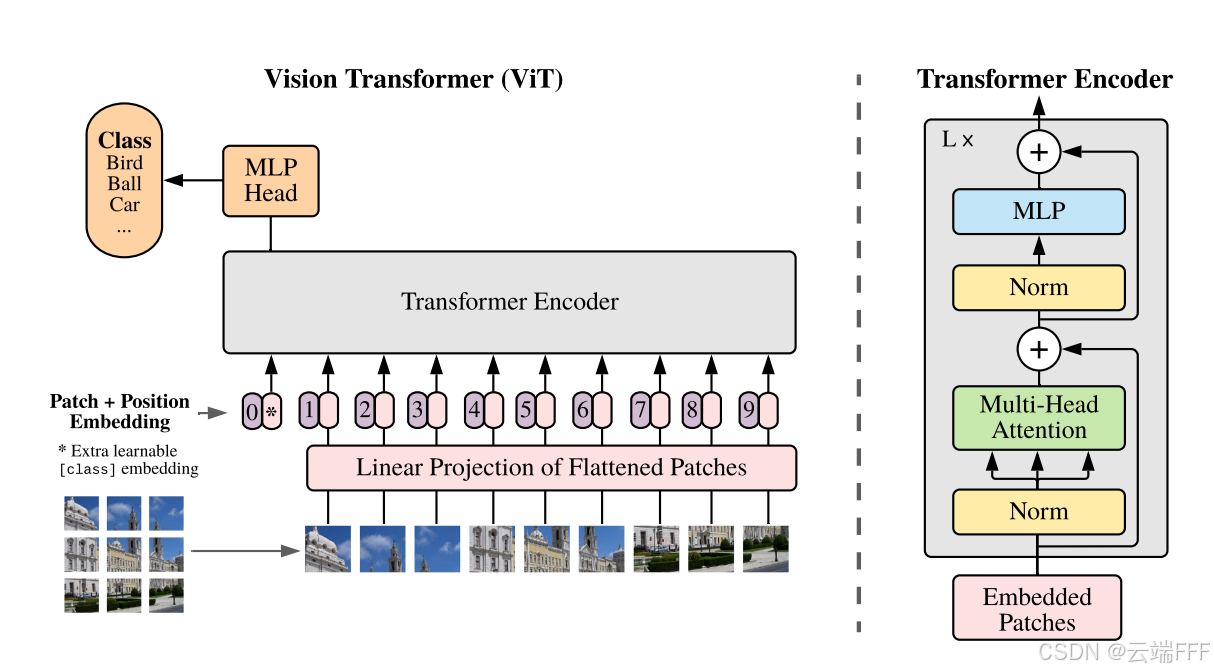
论文理解【Vision Transformer】——【VIT】An Image is Worth 16x16 Words-Transformers for Image Recognition at Scale VIT将图像切分成16x16的patch块,通过标准Transformer进行图像分类,在引入尽量少图像归纳偏置的情况下,验证了纯Transformer在图像分类任务中的有效性,为CV和NLP的模型统一奠定基础。 2025-09-10 机器学习 > 论文理解 > Vision Transformer #CV #Transformer-Based #Vision Transformer #CV backbone
论文理解【Vision Transformer】——【Swin Transformer】Hierarchical Vision Transformer using Shifted Windows Swin Transformer 是首个在通用视觉任务上全面超越 CNN 的 Transformer-Based 通用 CV 骨干网络。该模型借鉴 CNN 中的卷积和池化操作,将注意力计算约束在可重叠的图像patch内部,使计算复杂度与图像大小呈线性关系 2025-09-10 机器学习 > 论文理解 > Vision Transformer #CV #Transformer-Based #Vision Transformer #CV backbone
论文理解 【LLM-RL】——【EndoRM】Generalist Reward Models-Found Inside Large Language Models 本文发现任何通过标准next token prediction训练的LLM内部已隐含通用奖励模型,并基于逆强化学习提出一种从预训练模型中直接提取内生奖励函数的方法,为LLM对齐提供了新的理论基础和实践路径。 2025-09-08 机器学习 > 论文理解 > LLM-RL #LLM-RL #LLM #RL #EndoRM
经典机器学习方法(6)——非线性支持向量机与核技巧 本文介绍非线性支持向量机(SVM)及其核技巧,包括核函数的定义与常见类型,通过映射函数解决非线性分类问题,并利用 sklearn 实现非线性SVM。 2025-09-08 机器学习 > 实践 #机器学习 #SVM #sklearn
经典机器学习方法(5)——线性支持向量机 本文介绍支持向量机(SVM)的硬间隔最大化和软间隔最大化原理,包括线性可分SVM与线性SVM的优化问题建模、对偶算法及Python实现。 2025-09-08 机器学习 > 实践 #机器学习 #SVM #sklearn