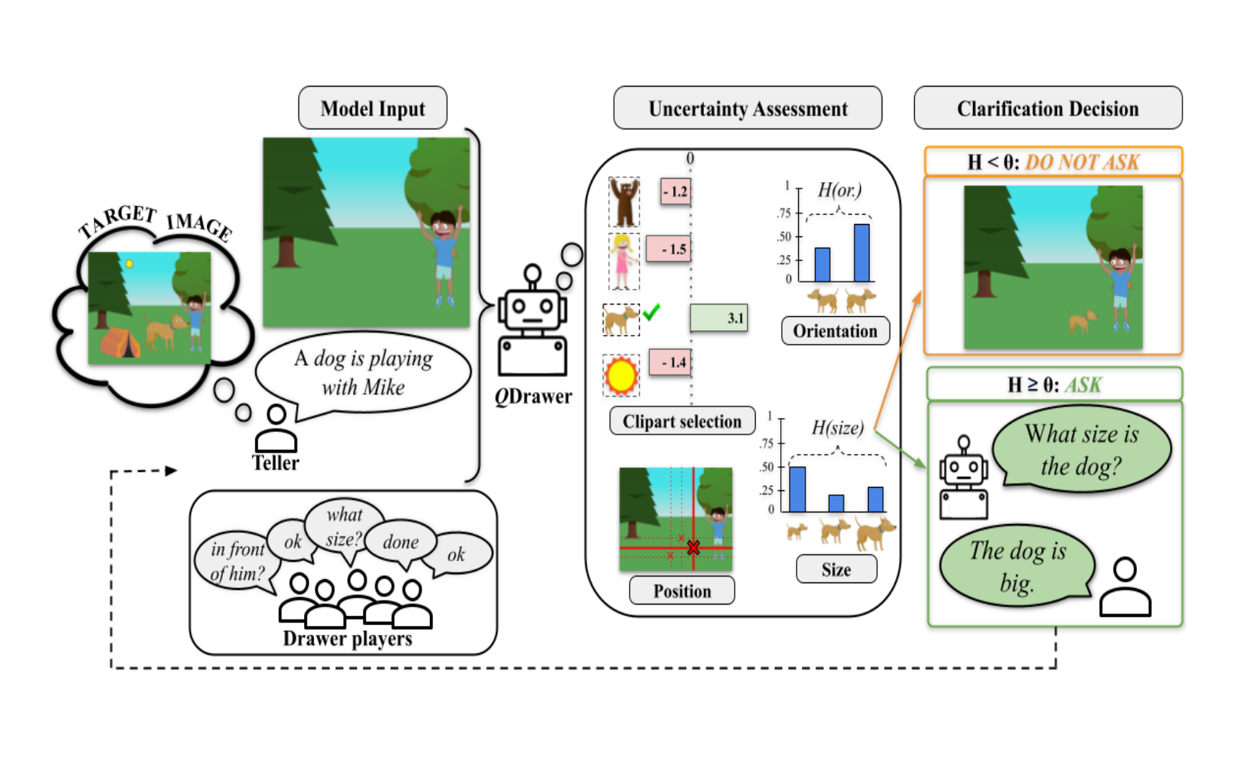
论文理解【LLM-Clarification】——【QDrawer】Asking the Right Question at the Right Time 本文基于 CoDraw 任务对 LLM 澄清提问的触发方式进行探索,发现模型内部不确定性与人类澄清决策相关性弱,使用不确定性阈值触发澄清提问相比模仿人类提问时机,性能和计算效率都更好 2026-02-05 机器学习 > 论文理解 > LLM-Clarification #LLM #LLM-Clarification
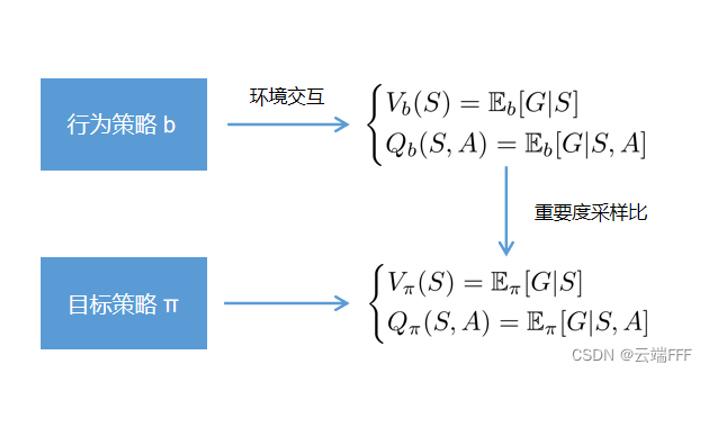
强化学习拾遗 —— Off-policy 方法中的重要性采样比 考虑一个问题:为何基于 DQN 的 PER 需要重要度采样比,而基于 Q-learning 的优先级 Dyna-Q 则不用 2026-02-02 机器学习 > 强化学习 #强化学习
强化学习拾遗 —— 表格型方法和函数近似方法中 Bellman 迭代的收敛性分析 本文考察表格型 model-based evaluation 方法中,使用 Bellman 算子进行迭代的收敛性:首先补充一些测度论中的定义,然后介绍压缩映射原理和不动点,最后证明收敛性 2026-02-02 机器学习 > 强化学习 #强化学习
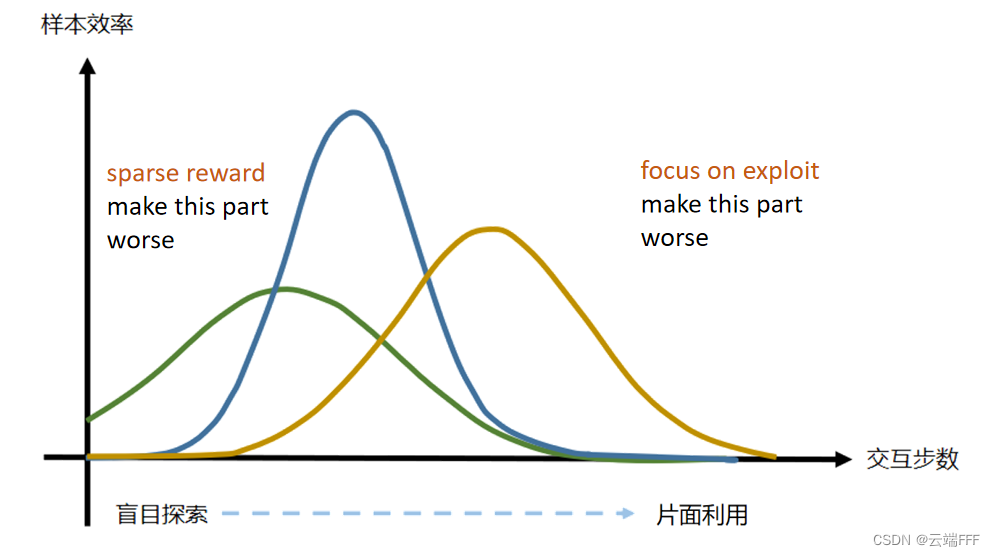
强化学习拾遗 —— 强化学习的样本效率 总所周知,样本效率低下是强化学习的一个重要问题,本文试图从本质上分析造成这一问题的原因,并简单介绍一些改进措施 2026-02-02 机器学习 > 强化学习 #强化学习 #样本效率
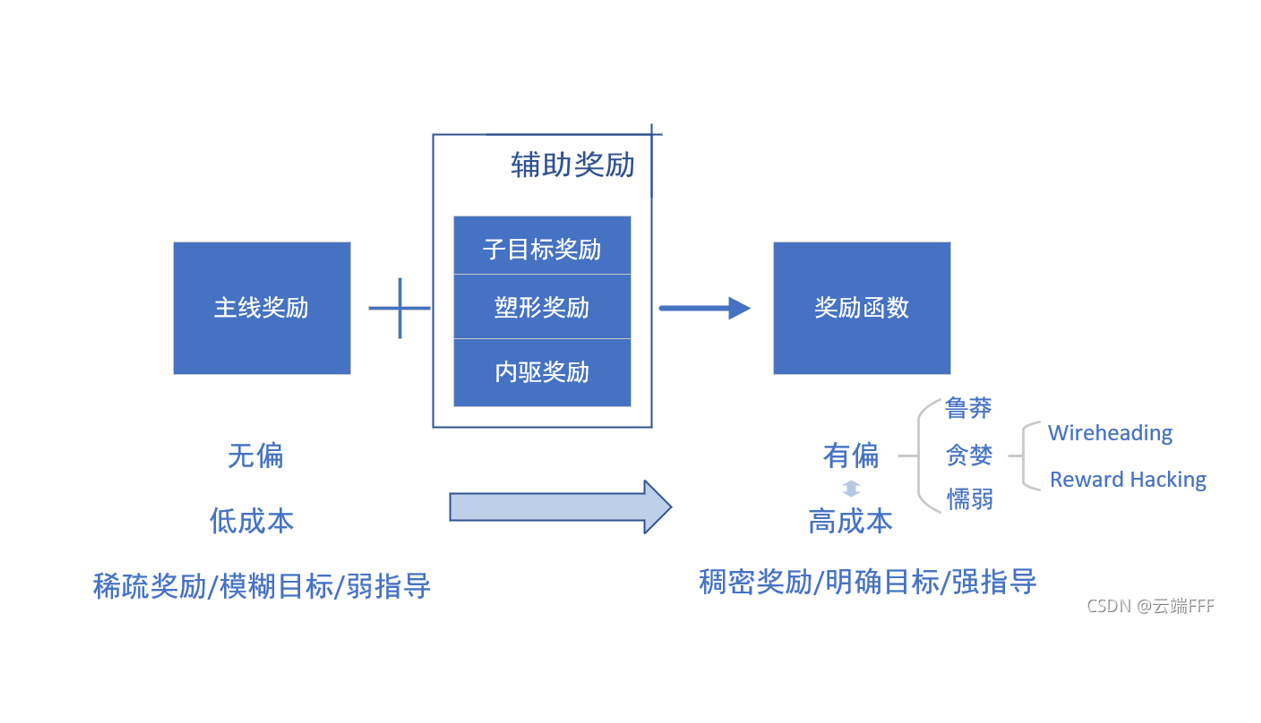
强化学习拾遗 —— 再看奖励函数 本文介绍设计奖励函数的一般思路及面临的困境,对奖励函数的本质进行分析,从更高的角度建立对奖励函数的深刻认识 2026-02-02 机器学习 > 强化学习 #强化学习 #奖励函数
论文理解【LLM-OR】——【Step-Opt】Training LLMs for Optimization Modeling via Iterative Data Synthesis and Step-opt 是一种针对 LLM 求解运筹优化任务的数据增强框架,其通过用迭代问题生成 + 分步验证机制实现更可靠的训练数据合成,并微调开源 LLM 得到 Step-Opt,在多个 OR 建模基准提升性能,尤其在复杂问题上提升更明显 2026-01-31 机器学习 > 论文理解 > LLM-OR #LLM #LLM-OR
论文理解【LLM-OR】—— 【PaMOP】Guiding large language models in modeling optimization problems via question partitioning 针对 LLM 求解运筹优化任务,PaMOP 通过约束划分树分离子问题,实现复杂优化问题的分块建模,降低子任务复杂度;结合求解器反馈与反向翻译一致性检查迭代纠错,实现建模逻辑错误识别与纠正,提升了建模准确性。 2026-01-25 机器学习 > 论文理解 > LLM-OR #LLM #LLM-OR
论文理解【LLM-OR】——【ORLM】Training Large Language Models for Optimization Modeling LLM 有能力将自然语言描述的工业场景问题建模为数学运筹优化问题,然后通过写代码调用经典求解器的方式加以解决。本文提出的 ORLM 方法主要关注如何合成数据来训练或微调这种领域模型 2025-12-29 机器学习 > 论文理解 > LLM-OR #LLM #LLM-OR
论文理解【LLM-OR】——【OptiTree】Hierarchical thoughts generation with tree search for LLM optimization model 使用 LLM 对运筹优化问题(OR Problem)建模时,传统固定步骤分解在复杂数学结构下准确率低,本文提出 OptiTree:基于“子问题层级建模树”的树搜索检索,自适应地将原问题分解为一串更简单的子问题,并递归整合各子问题的高层建模思路形成全局指导,从而显著提升建模准确率 2025-12-29 机器学习 > 论文理解 > LLM-OR #LLM #LLM-OR